GEO 信源生态与集中度:AI 搜索引用有多集中?
AI 搜索究竟引用谁?做 GEO(生成式引擎优化)时,这个问题比“文章里放几个关键词”更接近实际:内容需要被发现,也需要在具体问题下成为回答可采用的材料。
本文选取 CN-GEO 多维数据分析报告第三章 的信源数据,重点看两件事:不同类型的信源贡献了多少引用,以及引用向头部集中到什么程度。
在这份样本中,Top 10 信源贡献了 41.47% 的可关联信源去重引用。 这能说明样本中的分布不均衡,但不能据此计算一篇个人博客被引用的概率。
先分清信源、页面与生态归属
分析引用之前,需要先确定数的是什么。同一篇文章可能被多次引用,同一个域名可能承载很多作者,而同一个企业也可能运营多个域名。
本文使用的几个单位分别是:
- 信源:数据集归一化后的域名单位,不直接等于作者、公司或企业集团。
- 页面:归一化后的 URL。同一信源可以包含许多页面。
- 引用记录:采集到的一次引用观察。去重记录也不直接等于独立回答数。
- 信源类型:平台社区、新闻媒体等分类标签。
- 生态归属:来源所属的平台或组织生态,与内容类型是两个维度。
例如,一个门户域名中的文章可能来自媒体、机构或个人账号。研究“哪个平台入口出现得多”和研究“谁生产了内容”,需要不同的识别粒度;必要时应继续核对作者账号和原始发布页。
这也影响“未分类”的解释。报告中,信源类型未分类的是 150 个,未归属生态的是 8,657 个。前者缺少类型标签,后者缺少生态归属,不能混为一组,更不能直接称为“不可信网站”或“个人博客”。
统计分母为什么不能混用
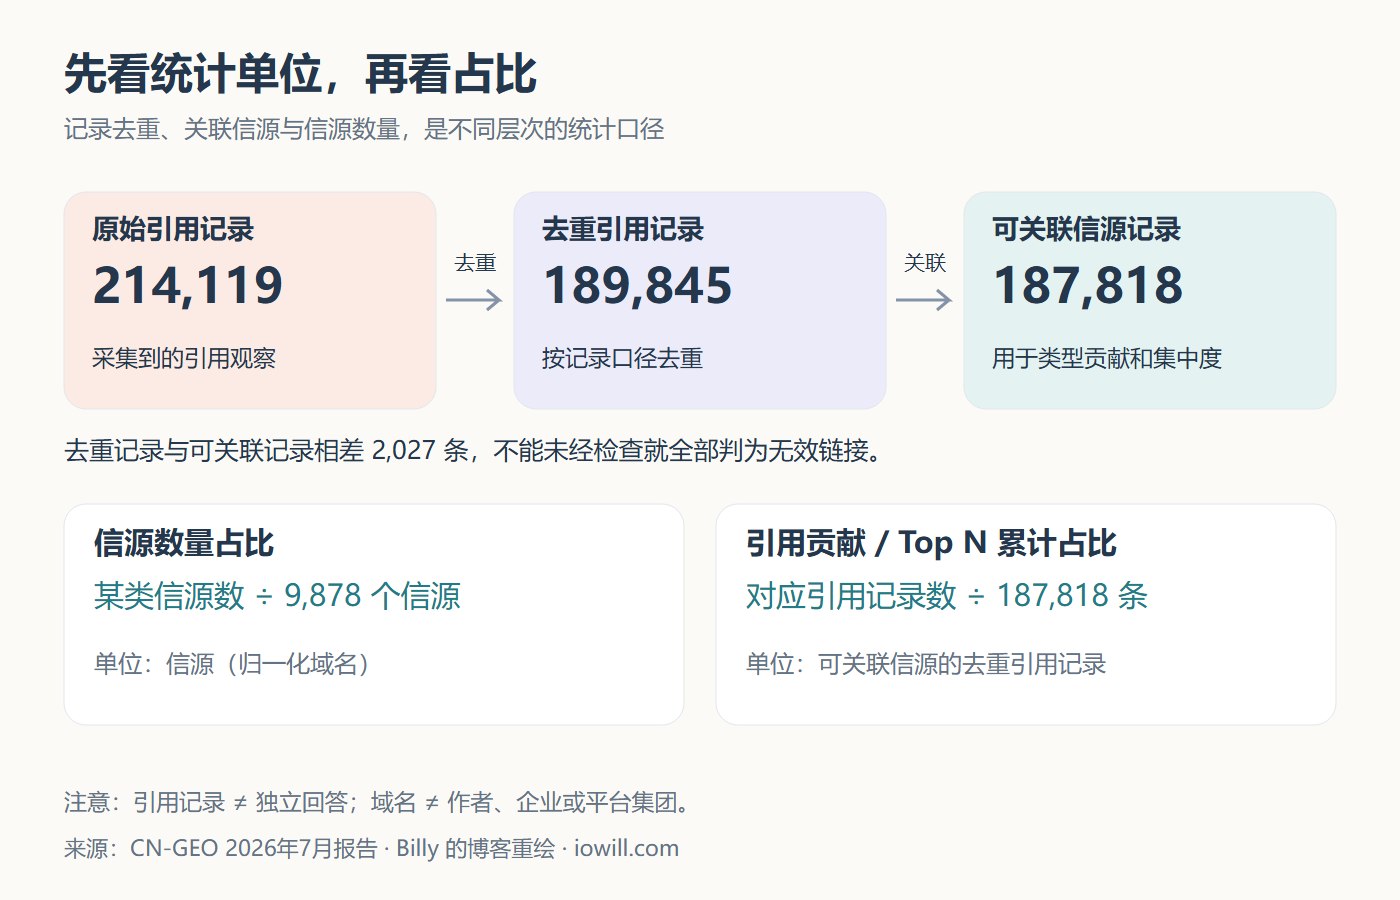
本文于 2026 年 10 月 24 日核对报告。数据集发布日为 2026 年 7 月 14 日,报告生成时间为 7 月 21 日;它是既有样本的分析,不是 10 月各产品实时算法的测量。
报告覆盖 620 个问题、12 个产品/终端口径。网页版与 App 会分别计入,这里的“12”不代表 12 家独立公司。
| 统计范围 | 数量 | 本文用途 |
|---|---|---|
| 原始引用记录 | 214,119 | 理解采集规模 |
| 去重引用记录 | 189,845 | 理解清洗后的总体规模 |
| 可关联信源的去重引用 | 187,818 | 类型引用占比、Top N 集中度的分母 |
| 信源 | 9,878 | 信源数量占比的分母 |
后文的 41.47% 是 77,890 ÷ 187,818,不是除以全部原始记录,也不是除以问题数。189,845 与 187,818 相差 2,027 条,表示两种统计范围不同;不能未经逐项检查便将差额全部判为无效链接。
上游去重采用记录哈希口径,也不能简化成“每个 URL 只算一次”。更关键的是,数据缺少可稳定恢复独立回答边界的标识,因此这里不把引用条数换称为“回答次数”。相关字段限制见数据集中文说明。
哪些类型贡献了更多引用
下表按报告分类列出信源数量及其引用贡献。百分比四舍五入到小数点后两位,两列占比使用不同分母。
| 信源类型 | 信源数量 | 信源数量占比 | 引用贡献占比 |
|---|---|---|---|
| 平台与社区 | 462 | 4.68% | 29.63% |
| 商业信息与服务 | 2,817 | 28.52% | 23.06% |
| 新闻与媒体 | 920 | 9.31% | 20.50% |
| 垂直专业内容 | 1,899 | 19.22% | 10.59% |
| 政府与公共机构 | 1,479 | 14.97% | 4.74% |
| 品牌与企业官网 | 1,868 | 18.91% | 4.33% |
| 搜索与页面代理 | 48 | 0.49% | 4.00% |
| 研究与文档 | 235 | 2.38% | 2.92% |
| 未分类长尾 | 150 | 1.52% | 0.23% |
平台与社区的信源数量占比为 4.68%,引用贡献却达到 29.63%;商业信息与服务的信源数量较多,引用贡献则为 23.06%。这说明按域名数观察的结构,与按引用记录观察的结构有明显差别。
不过,大平台域名下可能聚集海量内容。把一个社区域名与一个个人网站各计为一个信源,并不意味着它们拥有相同的页面数量、主题覆盖或内容供给。
因此,两列比例的差异不能解释成“某类文章获得了多少倍算法加权”。本表既没有全部待引用页面的规模,也没有曝光次数,无法计算单页引用概率。
分类标签也有误差边界:报告记录了 8,644 个模型辅助分类信源,不能将整张表理解为逐站人工审定的结果。针对重要站点下结论前,应回看标签与页面。
Top 10 占 41.47%,集中到什么程度
集中度回答的是:按引用量排序后,前 N 个信源合计占了多少记录。
| 范围 | 合计引用记录 | 累计占比 |
|---|---|---|
| Top 5 | 49,369 | 26.29% |
| Top 10 | 77,890 | 41.47% |
| Top 20 | 97,910 | 52.13% |
| Top 50 | 117,409 | 62.51% |
| Top 80 | 126,667 | 67.44% |
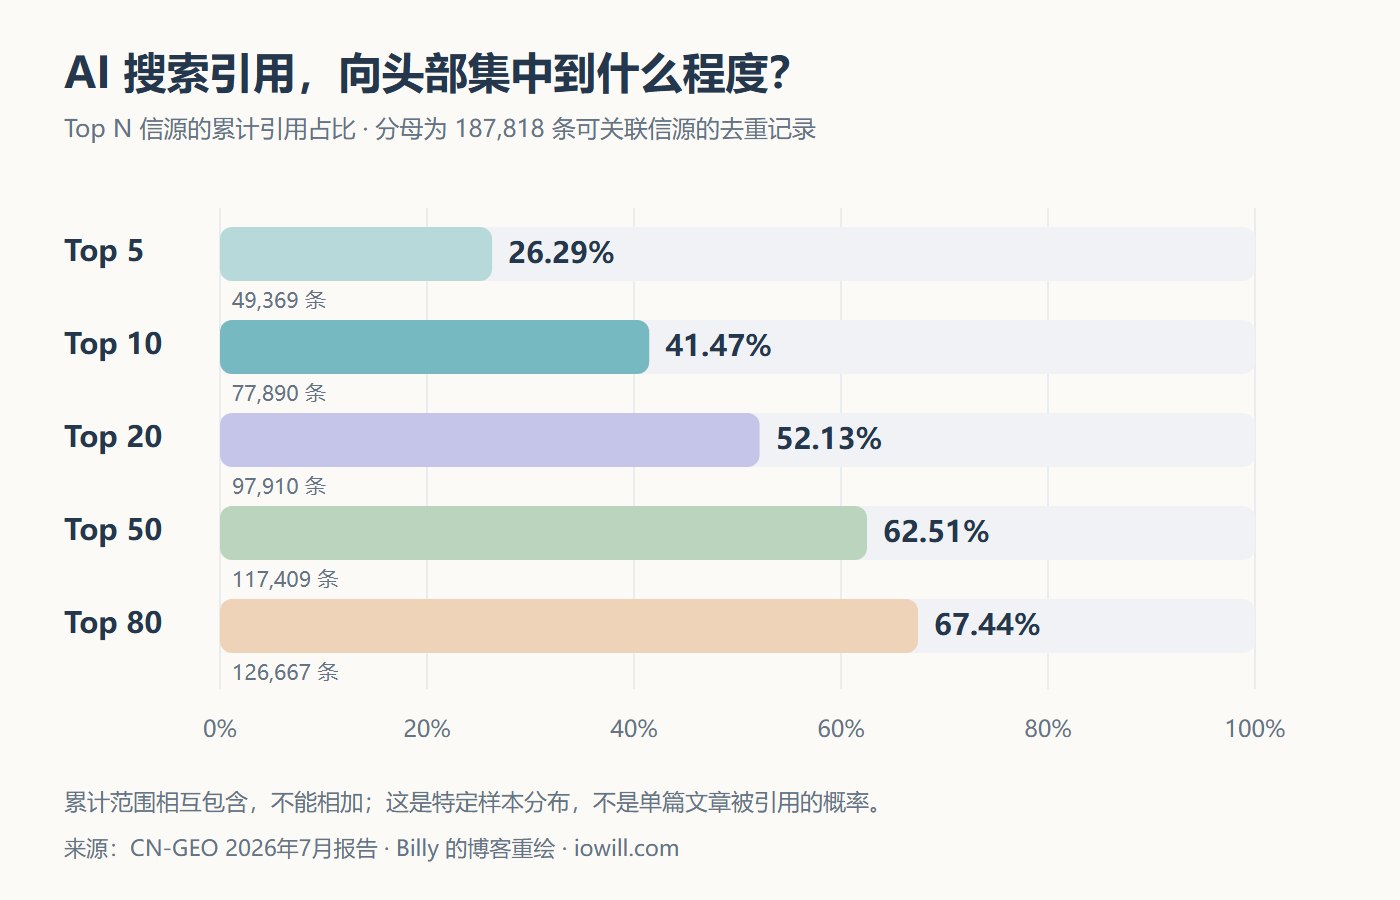
Top 10 合计占 41.47%,Top 20 超过一半,Top 80 达到 67.44%。这是一种明显的头部聚集,但表中的 N 是信源个数,不能拿 Top 20 直接套成“二八定律”。
前十名依次为抖音、腾讯网、今日头条、百度百科、手机搜狐网、买购网、什么值得买、sm.cn、网易和品牌网。名单同时包含内容平台、门户、百科及搜索相关入口,所以它首先是引用入口分布,不能直接当作内容质量或权威性排行榜。
如果要研究原始内容生产者,还需要沿引用 URL 检查:页面是谁发布的,是否转载,引用经过了什么入口。同样,“出现了引用”也不自动意味着 AI 对页面全部观点表示认可。
Top 10 之外仍有 58.53% 的记录,但这部分分布在其他各类信源中,并不是个人博客独占的空间。另一方面,头部集中也不足以推出“个人博客没有机会”:全局榜单没有告诉我们,在某个很具体的技术问题下,哪些页面提供了可复核的证据。
全局榜单为什么不能直接当成平台偏好
将所有产品合在一起统计时,引用记录较多的产品/终端也会对总榜产生更大影响。总榜既反映来源分布,也受到样本问题和采集规模的影响。
例如,在报告全范围的分产品结果中,豆包网页版的首位信源是抖音,腾讯元宝网页版是腾讯网,千问网页版是 sm.cn。这些是样本中的描述性结果,尚不足以证明某个算法主动偏袒自家生态。
要进一步讨论偏好,应尽量控制问题集合、问题措辞、终端、采集时间和会话条件,再比较相同问题下的结果。否则,产品之间的差别可能混入问题覆盖与场景差别。
同理,不能用这份数据的引用总量推算产品市场份额,也不能把未在样本里出现的网站判定为“永远不会被收录”。样本没有覆盖所有问题,更没有覆盖互联网上全部可引用页面。
其他研究能补充哪些证据
目前这篇文章的 41.47% 仍只来自 CN-GEO。要检验“集中度值得关注”是否也出现在其他场景,可以参考独立研究;但语言、产品、问题集和链接提取规则不同,不能将各研究的百分比拼成同一份排行榜。
头部集中在其他样本中也有出现
Pew Research Center 的原始分析基于 900 名美国成年人的浏览数据,获得 68,879 个不同 Google 搜索,并在 2025 年 4 月重跑搜索采集结果。其方法最多提取每条 AI 摘要中的三个来源 URL;Wikipedia、YouTube 和 Reddit 合计占所提取摘要信源的 15%。这说明特定入口在该样本中较常见,但不能拿这个数字与 CN-GEO 的全局 Top 10 直接比较。
更直接讨论集中度的是 From Public Posts to AI-Search Citations。这份 2026 年 10 月 8 日公开的 arXiv 稿件分析了 10 个平台的 17,211 次引用、6,356 个不同来源域名,报告各平台 Top 20 域名占比介于 20.5%—70.8%。这是该稿件的样本结果,本文按 arXiv 公开版本引用,尚未独立复现,也不据此宣称所有产品都有相同集中度。
另一份 News Source Citing Patterns in AI Search Systems 使用 AI Search Arena 数据,发现新闻引用向少数媒体聚集。它研究的是新闻来源子集,而非全部网站;本文按 2025 年预印本使用。该研究与后文 Cambridge 论文都使用 Arena 系列数据,不能将它们当作完全独立的采样重复验证。
这些材料分别支持“特定来源反复出现”“平台间集中程度不同”和“新闻子集也存在头部聚集”三个较窄的判断。它们没有给出适用于全网的统一阈值。
被检索、被引用与引用正确是三个问题
发表于 Data & Policy 的 The attribution crisis in LLM search results 分析了 2025 年 3—4 月的 LMArena 搜索日志,区分系统访问的相关 URL 与最终署名的 URL。它为“被读取不等于被展示为引用”提供了研究依据;但不同供应商日志披露程度不同,日志也不代表系统全部内部行为。
ACL 正式收录的 Evaluating Verifiability in Generative Search Engines 则将可核验性分为两部分:回答是否得到充分引用支持,以及每条引用是否真的支持关联陈述。它研究的是 2023 年的四个系统,本文借用评估方法,不把当年的准确率当作今天的产品表现。
哥伦比亚 Tow Center 的原始测试报告还记录了新闻原文被错误归属、转载页替代原始来源和链接失效等问题。该研究任务是根据新闻片段识别原文,不能外推成所有日常搜索的错误率,但能说明:核对引用时,仅看域名是否知名还不够。
个人技术博客怎样做一轮引用观察
对个人博客而言,我更关心的是:在文章能回答的具体问题下,AI 是否引用了原始页面,以及引用是否准确。
以下是一套拟采用的观察方案,本文没有据此运行产品测试,也没有获得本站引用率提升的实验结果。
固定问题和采集条件
先选约 20 个与现有文章对应的具体问题,固定措辞。例如:
- Linux 删除日志后,为什么磁盘空间没有释放?
- Docker 容器中使用 localhost,为什么访问不了宿主机服务?
- Debian 双网卡环境中,Docker MySQL 外网连接失败,如何检查回程路由?
这些问题应能在文章中找到完整答案,不能为了凑关键词拼接不自然的问题。站内的磁盘空间排查文章就适合围绕已删除但仍被进程打开的文件,设计更具体的观察问题。
每次记录产品、终端、可见模型版本、采集时间、联网搜索状态及会话条件,并保留完整回答与引用 URL。跨日期复测时分开汇总,不把一次偶然命中当成稳定表现。
把引用、提及与错误分开记录
可以用以下字段建立表格:
1 | 问题编号,问题原文,产品,终端,模型版本,采集时间,会话条件,联网状态,执行状态,回答标识,完整回答存档,引用URL,是否引用本站,是否仅提及本站,引用是否准确 |
同一产品、终端、问题集和条件下,可自行定义一个观察指标:
1 | 本站引用回答占比 = 含有本站目标URL引用的有效回答数 ÷ 有效回答总数 |
这里的分子按回答计数,一次回答引用多个本站链接也只计一次。正常生成但没有引用的回答仍计入分母;超时、报错等情况单独记录,并在采集前约定有效性规则,不能看到结果后再剔除不利样本。
这个指标用于自己的后续观察,与报告的“引用记录占比”不同,不能直接横向比较。缺少完整回答和回答标识时,也不能从当前报告反推出这个指标。
改善文章证据,再观察结果
针对技术文章,我会优先补齐适用环境、版本、错误现象、排查命令、关键输出、结论与验证方法,并链接官方资料;已有操作失败的条件也应明确说明。
这些首先能帮助读者判断答案是否适用,也是便于后续检查引用准确性的做法。它们是否提高了 AI 引用表现,需要用固定问题持续观察,不能由本报告直接证明。
可以同时参考两家平台的官方说明:Google Search Central说明,AI Overviews 和 AI Mode 的支持链接需要页面已被索引并具备展示摘要的资格,不要求额外的专用 AI 文件或特殊结构化数据,符合要求也不保证展示。这是 Google 的产品规则,不能代替其他平台的规则。
Bing 官方的 AI Performance 说明提供引用次数、页面和 grounding queries 等观察入口,并明确引用次数不表示页面排名或权威性;检索词数据也只是部分引用活动的样本。若使用该工具,应注明所覆盖的微软产品范围,不能把它当作全平台引用统计。
作为研究背景,GEO 原始论文已被 KDD 2024 接收,并在特定基准与系统中评估内容调整对可见性的影响;其结果随领域而异。论文中的可见性指标、实验环境与本站后续观察不同,因此不能把实验中的最高提升幅度写成博客的预期收益。
关于 GEO 的基础概念,可以先读什么是 GEO;关于站点说明文件,可参阅 llms.txt 与 Hexo 博客。文件可访问、文章可抓取,与最终是否被某个产品引用,是不同环节。
阅读结果时还要保留哪些边界
这份数据适合观察特定样本的引用分布,但仍有几个不能跨过去的边界:
- 数据没有完整的模型版本与采集时间,不能据此判断今天的算法变化。
- 引用片段不是完整回答,不能直接推出推荐态度、品牌情绪或答案准确率。
- 标题和引用片段的内容特征不能替代全文分析,也不足以证明 FAQ、表格等格式造成了引用提升。
- 进入信源表的是已观察到的来源,并非全部候选网站,缺少估计单站被引用概率所需的总体。
对个人博客更有用的问题,是某篇文章能否清楚回答一个真实问题,证据是否可核对,以及相同条件下的多次观察是否支持改进有效。头部榜单提供了背景,具体内容仍要回到具体问题中检验。
参考资料
- CN-GEO 多维数据分析报告:第三章信源生态:本文类型与集中度数据来源,Top N 百分比按所列分母重新计算。
- CN-GEO 数据集 README:数据发布及项目说明。
- 数据集中文说明:统计单位、字段缺失与分析限制。
- 清洗后数据使用说明:表结构、归一化及使用口径。
- Pew Research Center:Google AI 摘要与链接行为(2025):原始研究,含采样与 URL 提取方法。
- From Public Posts to AI-Search Citations(2026,arXiv 公开稿):分平台域名集中度研究,未由本文复现。
- News Source Citing Patterns in AI Search Systems(2025,预印本):新闻引用子集研究。
- The attribution crisis in LLM search results(2026,Data & Policy):访问与署名差异,使用 2025 年日志。
- Evaluating Verifiability in Generative Search Engines(2023,Findings of EMNLP):引用完整性与正确性的评估框架。
- AI Search Has a Citation Problem(2025,Tow Center):新闻片段寻源测试。
- AI features and your website(Google 官方文档,2026-10-24 核对):Google AI 搜索的技术资格与边界。
- Introducing AI Performance in Bing Webmaster Tools(2026,Bing 官方):微软支持范围内的引用观察口径。
- GEO: Generative Engine Optimization(KDD 2024):可见性优化的原始研究,实验提升不等于本站收益承诺。