GEO 是什么?它真的能让大模型‘愿意推荐你’吗?
迁移说明:本文原发表于 Billy 原站,保留原发布时间,2026 年 10 月 8 日迁入本站并重新配图。迁移时保留主体结构,对效果保证、评价指标和平台机制的绝对化表述补充校注。文中历史研究或平台报告的数值受样本、版本与指标定义限制,不代表本站实测,也不构成收录、推荐或转化保证。
一句话剧透
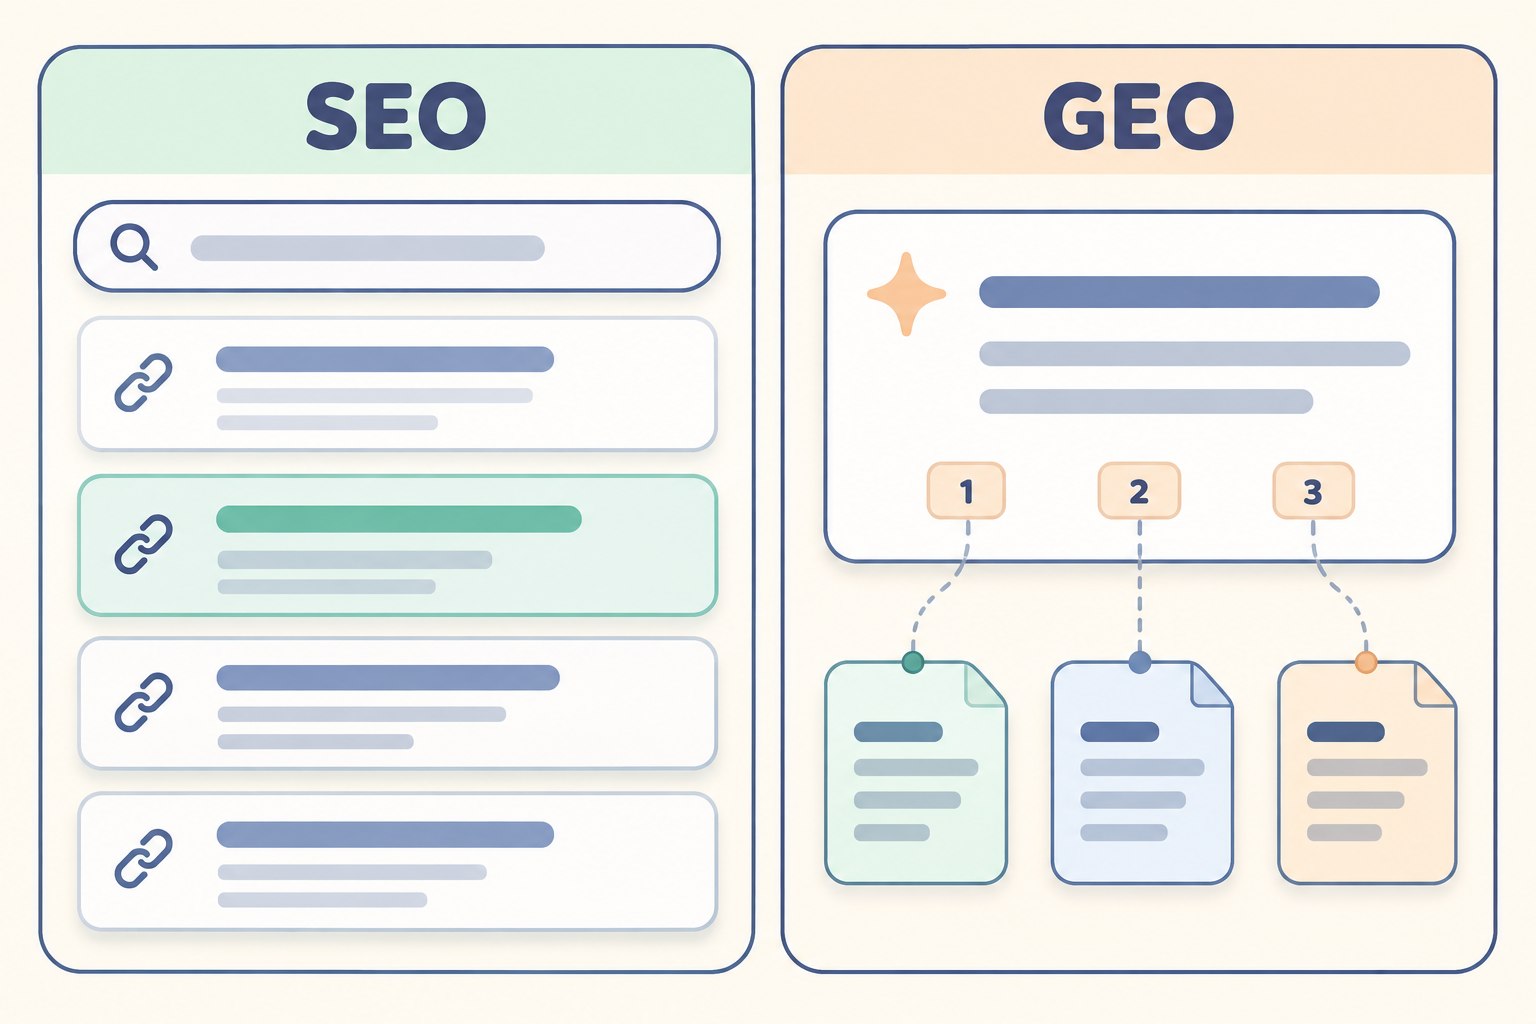
SEO 与 GEO 的侧重点不同:前者关注搜索可见性与访问,后者更关注内容是否进入生成式答案。两者存在交集,GEO 并不意味着可以跳过 SEO 基础工作。
一、为什么 SEO 不够用了
一句话定义:当用户在 Google 看到 AI Summary 而不再点击链接时,传统 SEO 的优化目标就从"前十名"坍缩成了"AI 答案里有没有我"。
五个事实点:
- chat.openai.com 单月 31 亿次访问(Similarweb,2024-09)。
- Perplexity 月查询量 7.8 亿(公司自报,2025-05)。
- Google 出现 AI Summary 时,点击率从 15% 跌到 8%(Pew 实地研究)。
- AI 答案可能改变用户是否继续点击网页的行为;原文此处百分比未明确对应统计口径,迁移版不保留该数值。
- 关于未来流量超过传统搜索的判断属于预测,不应作为已经发生的事实或确定的业务规划依据。
对比块:SEO vs GEO
| 维度 | SEO | GEO |
|---|---|---|
| 优化目标 | 在 SERP 排第几 | 是否被 AI 选进答案 |
| 用户行为 | 点 10 个蓝链之一 | 只看 AI 推荐的 3 个 |
| 排名机制 | 关键词 + 链接权重 | 预训练先验 + 检索片段合成 |
| 评估指标 | 排名 / CTR | 引用词数 / 位置 / 主观印象 |
| 失败模式 | 排不到首页 | 完全不被引用 |
二、GEO 到底在优化什么?
可见性评价:相关研究分别考察引用词数、位置加权词数和主观印象等指标。它们不是所有生成式引擎共同使用的一条排名公式,具体定义应以论文为准。
三个 visibility 指标:
- Word Count——AI 答案里有多少词在引用你。
- Position-Adjusted Word Count——被引用词数 ×
e^(-位置),靠前的引用权重大。 - Subjective Impression——用 G-Eval(LLM-as-judge)从相关性、影响力、独特性等 7 个子维度打分。
九种 GEO 方法(同样来自 Aggarwal et al., 2024):Authoritative、Statistics Addition、Cite Sources、Quotation Addition、Easy-to-Understand、Fluency Optimization、Unique Words、Technical Terms、Keyword Stuffing。
对比块:在 GEO-bench(10K queries)上的效果
研究记录:下表沿用原文整理的实验数据,本次迁移未重新复现实验;不同指标、样本与模型之间不可直接套用。
| 方法 | visibility 提升 | 实测备注 |
|---|---|---|
| Cite Sources + Quotation Addition + Statistics | +40% | 论文中最强组合 |
| 仅 Statistics Addition | +30% | 性价比最高 |
| Keyword Stuffing(传统 SEO 老套路) | < +10% | LLM 不吃这套 |
| 整体最高 | 40%(synthetic)/ 37%(Perplexity.ai 真实环境) | — |
三、检索信息与模型既有知识:为什么不同查询的表现不同
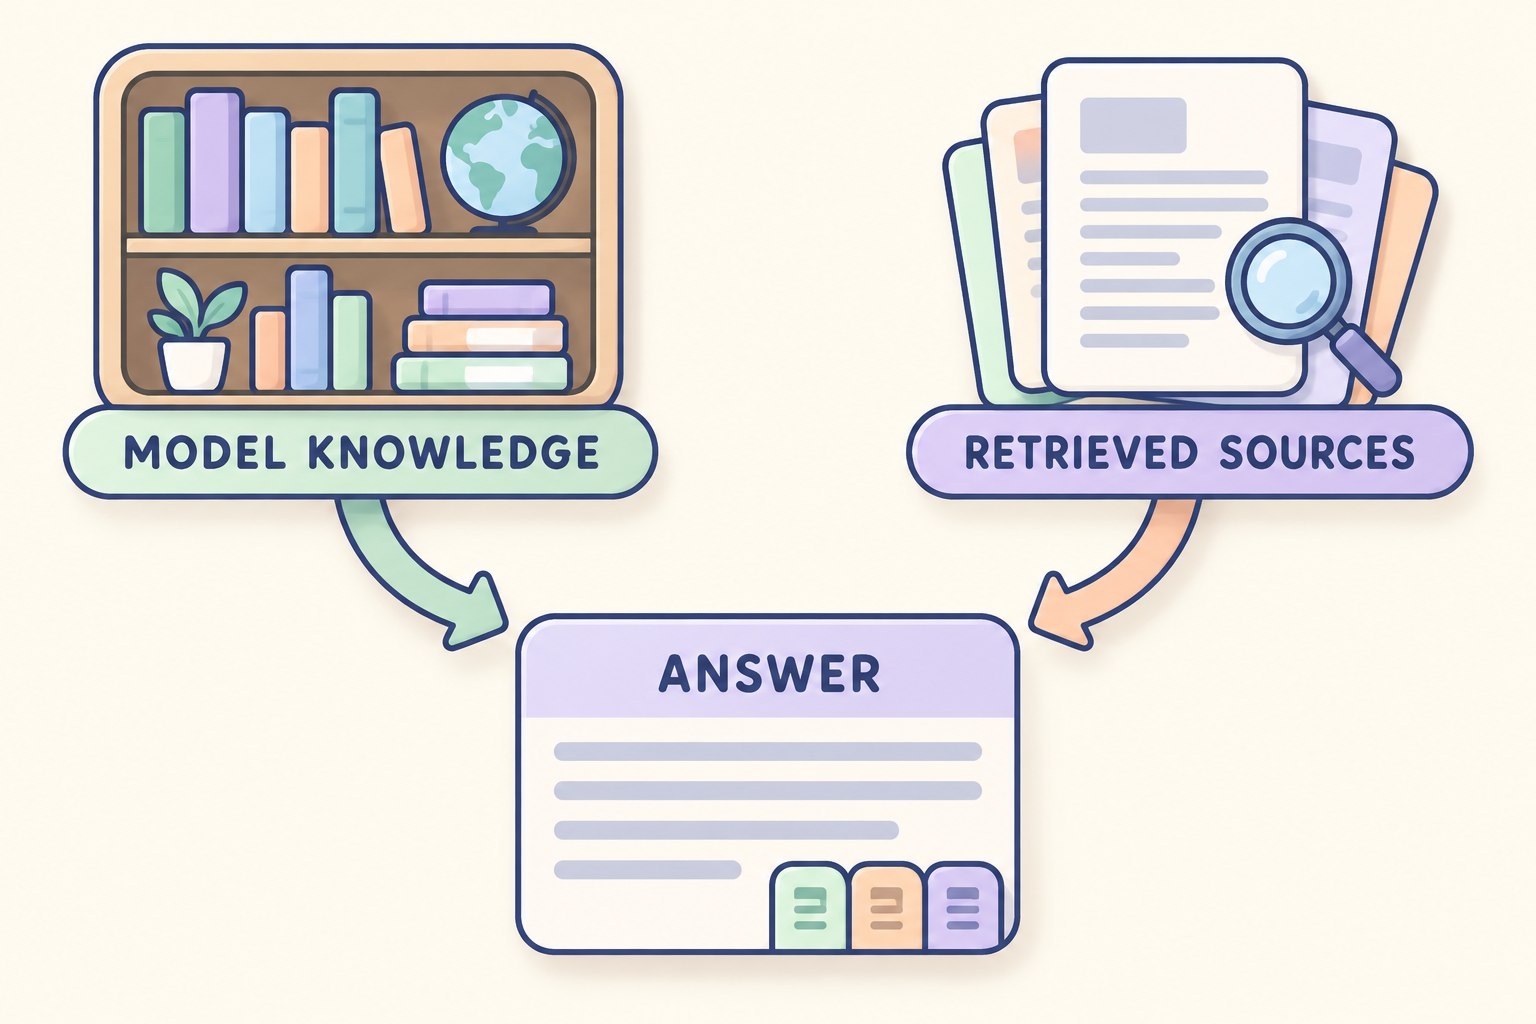
一句话定义:在主流 entity 查询上,模型用检索内容只是"给自己找个证据",而不是"获取新知识"。
三个扰动实验(Chen et al., EDBT/ICDT 2026):
- Snippet Shuffle——随机打乱检索片段顺序,看答案会不会变。
- Strict Grounding——强制模型只用提供的片段,禁止用预训练知识。
- Entity-Swap Injection——把片段里 A、B 两个实体的名字对调,看模型会不会上当。
对比块:主流 vs 小众 entity 的模型行为
研究记录:下表沿用原文整理的实验数据,本次迁移未重新复现实验;不同指标、样本与模型之间不可直接套用。
| 指标 | 主流 entity("最好的 SUV") | 小众 entity("多伦多家事律所") |
|---|---|---|
| 检索片段顺序打乱后排名变化 | 2.30 | 4.15 |
| 实体名互换后排名变化 | 2.60 | 4.63 |
| 一次性排序 vs 两两比较排序的 Kendall τ | 0.911 | 0.556 |
| 模型答出但根本没出现在检索片段中的 entity 占比 | 16% | — |
五个品牌的具体"幽灵率"(SUV 查询):
- Toyota:6%——几乎每个引用都有检索片段支撑。
- Honda:3%——同上。
- Kia:10%——基本可靠。
- Cadillac:58%——模型自顾自答。
- Infiniti:73%——纯靠预训练先验。
阅读结论:部分查询可能更受模型既有知识影响,但不能由局部实验推出“主流实体做 GEO 都无效”。应按查询类型、模型和实际结果判断。
四、GEO 真正能赢的四种场景
步骤块:判断 GEO 对你是否有用的四问
- 你的实体够小众吗?——B2B SaaS、本地服务、长尾知识、专业工具。模型脑子里没货,必须检索。[必做] 做 GEO。
- 你的内容够新鲜吗?——AI 引擎对 freshness 的权重显著高于 Google。消费电子垂直:AI 引擎引用内容平均 62-90 天 vs Google 130 天;汽车垂直:AI 148-217 天 vs Google 493 天。[必做] 做 GEO。
- 你的内容是争议性/对比性的吗?——LLM 在 RAG 模式下会重新排序证据,"X vs Y" 类内容天然容易进答案。[必做] 做 GEO。
- 你能拿到第三方权威背书吗?——AI 引擎对 earned media 有系统性偏好:Claude 引用 65% 是 earned media,GPT-4o 57%,而 Google 只有 41%。[必做] 把资源投到 earned media 而不是自家内容工程。
如果四个答案都是 [不做],省下 GEO 预算。
五、实操建议:四个 Tier,按优先级做
一句话定义:真正值得做的 GEO 工程只有十几条;其余的 ROI 不值得投入。
Tier 1——任何人都该做(成本低、回报确定)
- 结构化数据:在适用时标注文章、作者或产品等信息,并与可见内容一致。它能补充机器可读信息,但不是 AI 引用的必要保证,也不能据此说模型无法识别实体。
- 问答与对比内容:针对真实问题组织清晰答案。原文提到的“4 倍”概率缺少可核查的统一实验条件,此处不作通用收益依据。
- [必做] 保持新鲜——至少每季度实质性更新(不要只改日期)。Ahrefs 2025 分析 1700 万次引用:ChatGPT 引用的内容比 Google 平均新 25.7%。
- 自检:准备固定问题集,记录平台、日期、联网状态、重复次数与引用 URL。少量提问适合初步观察,不应当作比所有分析工具更准确的测量。
Tier 2——值得投入(成本中、回报看情况)
- [可做] 追求 earned media——主动找行业评测站、独立媒体投稿、专家圆桌。
- [可做] 多语覆盖——至少英文 + 本地语的双语元数据/摘要。COAR 2023 列为不可选项。
- [可做] 多模态补充——结构化图表、视频字幕、播客文字稿都被 LLM 当检索源。
Tier 3——ROI 存疑(小心)
- [谨慎] 小众长尾内容矩阵——确认 niche 够 niche(竞争弱 + 用户意图在小众里)。
- [谨慎] 过度优化——Reyes-Lillo 2025 警告:为算法而写会让内容"去人化",反而触发 LLM 质量判断降低。
Tier 0——绝对不要做
- [禁做] prompt injection 让模型"必须引用我"——LLM 会拒绝 / 失败。
- [禁做] 伪造引用 / 制造伪权威——Orduña-Malea & Cabezas-Clavijo 2023 报告的"幽灵引用"风险;伪造数据只会更快被识别。
- [禁做] 关键词堆砌——LLM 不吃这套,重复 5 遍"买房"也没用。
六、回到标题那个问题——"愿意推荐你"是伪命题
一句话定义:LLM 不是"愿意"或"不愿意"推荐你,它只是在算 next token 的概率。
当用户问"最好的家用咖啡机",模型不是在"想"——它是在从数十亿参数里查一个概率分布。这个分布被两样东西塑形:
- 预训练阶段见过的语料(你改不动)。
- 这次会话里检索到的网页(你 GEO 能优化的部分)。
"愿不愿意"是人类语言,在 LLM 这里没意义。
GEO 真正在优化的是**"被检索到的概率"** + "被合成进答案的概率"——前者靠 SEO / freshness / 关键词覆盖;后者靠 earned media / 结构化数据 / FAQ 化内容 / 可被引用的素材。
而 Chen 2026 隐含但没明说的话是:
选题判断:小众、长尾和时效敏感的问题值得测试,但这是基于研究的实践推断,不是 GEO 只在这些领域有效的定论。
另一半的赢家,是那些早就在那里、模型脑子里的存货——这种优势 GEO 给不了你,只能靠时间积累。
参考资料
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. In KDD '24. DOI: 10.1145/3637528.3671900.
- Chen, M., Wang, X., Chen, K., & Koudas, N. (2025). Generative Engine Optimization: How to Dominate AI Search. arXiv:2509.08919.
- Chen, M., Wang, X., Chen, K., & Koudas, N. (2026). Navigating the Shift: A Comparative Analysis of Web Search and Generative AI Response Generation. In EDBT/ICDT 2026 Workshops. arXiv:2601.16858.
- Reyes-Lillo, D., Morales-Vargas, A., & Rovira, C. (2025). Generative Engine Optimization en repositorios digitales: optimización de la visibilidad para la IA generativa. Infonomy, 3(5). DOI: 10.3145/infonomy.25.034.
迁移校注与补充资料
Google 的 AI 搜索功能文档说明,现有 SEO 基础仍然适用,无需特殊的 AI 专用结构化数据。其内容质量文档也明确,E-E-A-T 本身不是一个具体排名因子。这些说明适用于 Google 的公开文档,不能直接代替其他服务的实现说明。
- Google:AI features and your website
- Google:Creating helpful, reliable, people-first content
- GEO: Generative Engine Optimization:摘要中的最高提升值属于实验结果,不是单个网站的收益保证。
相关阅读:如何做好 GEO 优化