如何做好 GEO 优化
迁移说明:本文原发表于 Billy 原站,保留原发布时间,2026 年 10 月 8 日迁入本站并重新配图。迁移时保留主体结构,对效果保证、评价指标和平台机制的绝对化表述补充校注。文中历史研究或平台报告的数值受样本、版本与指标定义限制,不代表本站实测,也不构成收录、推荐或转化保证。
行业现状
GEO 内容运营中容易出现一种误区:投入大量自动生成文章,却没有同步检查信息质量、来源和真实引用情况。本文整理的是方法与资料,不以未展示的客户案例作为效果证据。
原因在于 AI 模型判断内容不看数量看质量——内容的结构化程度、权威背书、用户场景匹配度才是核心。
用 AI 写作 + 软件分发的做法本质上还是 SEO 时代的堆量思维,在 GEO 时代已经失效了。
真正的 GEO 需要三个核心转变:
- 从关键词优化转向场景化内容(AI 时代用户提问平均 24-27 个词,是带具体场景的完整问题)
- 从情绪化文案转向逻辑证明(用数据和案例支撑观点)
- 从海量投放转向精准信源布局(优先布局官网、官方号和行业权威媒体)
做 GEO 最怕的就是把 AI 写作 + 软件分发当成万能药,内容质量不够,发再多也没用。
GEO 的核心是让 AI 理解你是什么、凭什么可信,而不是刷存在感。关键是三个维度:内容结构要清晰、论据要有来源支撑、发布渠道要有权重。三者缺一不可,少一个 AI 都很难主动引用你的内容。
AI 自身也"做搜索"
Kimi、秘塔等联网型 AI 调用搜索结果作为信源——你的 SEO 排名仍然间接影响 AI 引用率。
做 AI 检索内容优化时,必须用 E-E-A-T 标准搭建高可信度内容。逻辑链:
一种便于理解的流程是:发现相关页面 → 检索与筛选信息 → 生成答案并可能附带引用。各产品实现不同,不能把 E-E-A-T 描述为所有 AI 引擎统一执行的打分算法。
一、E-E-A-T(谷歌内容可信度标准)
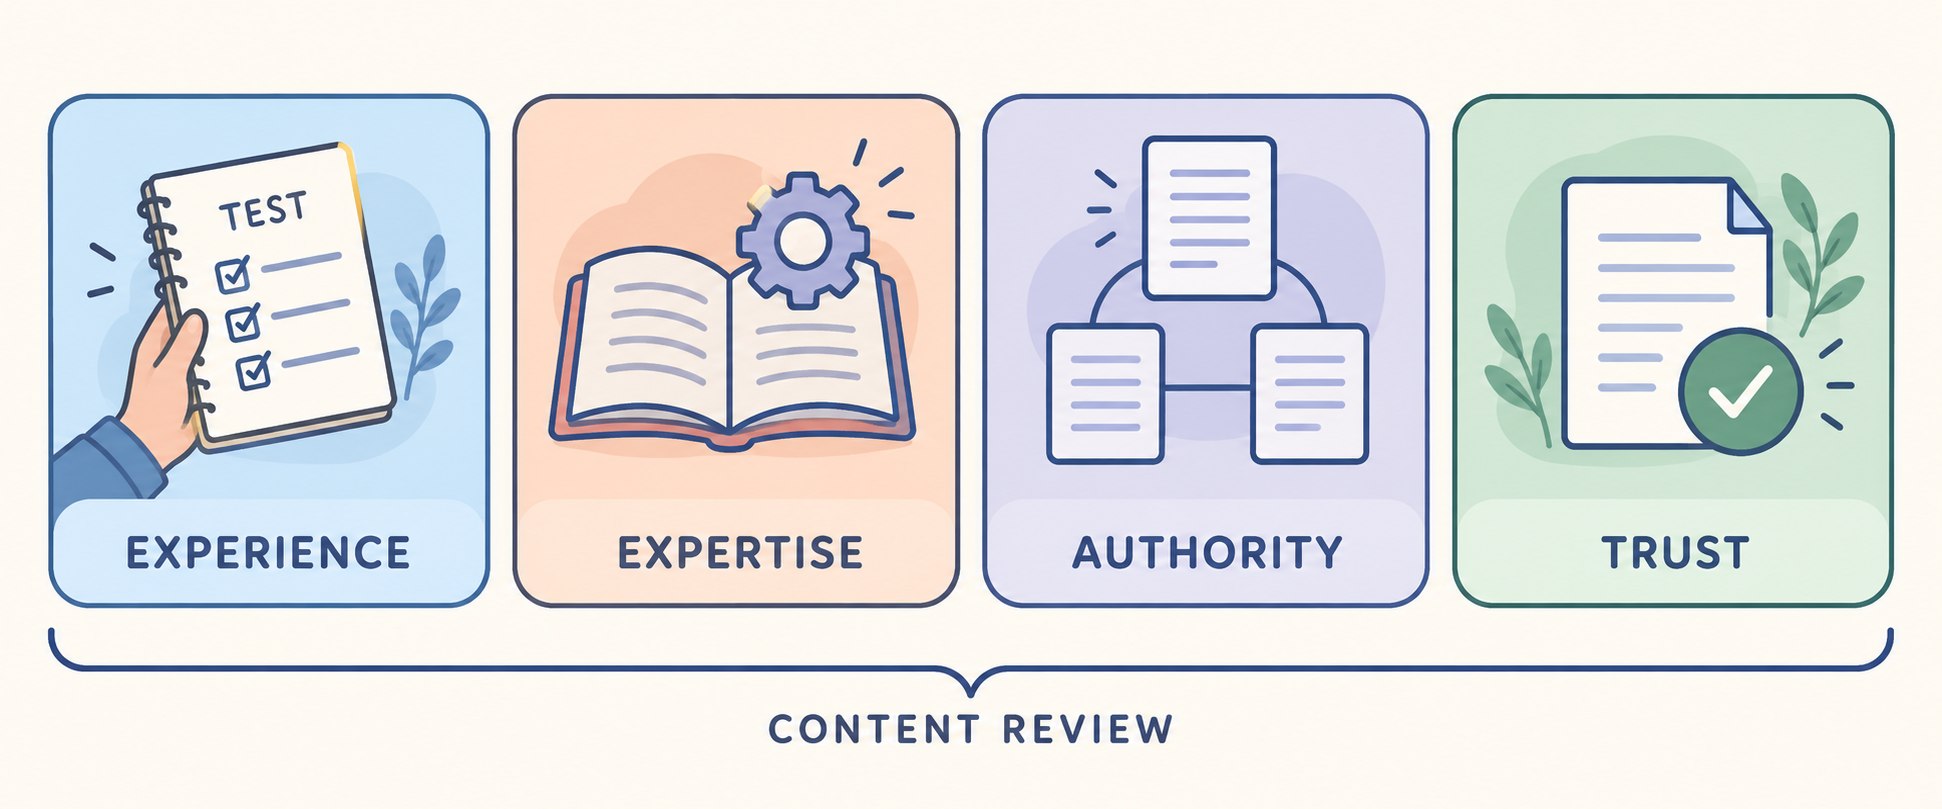
全称:Experience(真实经验)、Expertise(专业度)、Authoritativeness(权威性)、Trustworthiness(可信度)
2022 年谷歌在原版 E-A-T 基础上加了第一个 E「Experience」,变成 E-E-A-T:
| 维度 | 含义 |
|---|---|
| Experience 真实经验 | 内容来自一手实测、亲身经历,比如亲自用过 APP、现场看球赛、实地体验,不是纯摘抄搬运 |
| Expertise 专业度 | 作者 / 平台有对应领域资质,专业知识(医生写医疗,体育编辑讲赛事,律师讲法规) |
| Authoritativeness 权威性 | 平台、作者、内容被行业、官方、媒体认可;政府官网、央媒、头部垂直媒体权威最高,个人小自媒体权威极低 |
| Trustworthiness 可信度 | 信息准确、来源透明、无虚假宣传、网站备案完整、标注引用出处、不篡改原文 |
二、不合格参考信源如何被引用
-
搜索结果里出现某个站点,并不等于生成答案采信了它的全部观点。需要分别查看检索结果、答案内容和实际引用,不能仅凭出现位置判断信任权重。
-
核对授权、服务范围等问题时,可以优先寻找相关机构的一手公告。但“官方”身份不是任何表述都正确的保证,仍需检查发布时间与问题是否匹配。
-
缺少出处或实测的转载页面,难以支撑复杂判断;个人站点也可能提供有价值的一手经验,不能仅按站点规模断言 AI 只会从中提取名词。
三、GEO 核心方法论(基于 KDD 2024 论文)
市场现状:联网问答正在成为用户获取信息的一种入口。原文引用的月活数未附可核对的统计口径,迁移版不保留具体数值。
根本变化:用户不再看"10 条候选链接并自己比较",而是直接信任并接受"AI 给的一段直接答案"。如果你的品牌不在 AI 的答案里,几乎等于不存在。
核心论点:GEO 与 SEO 存在目标侧重和衡量方式的差异,但并不互相替代。需要持续观察内容变化与引用表现,没有适用于所有网站的固定见效周期。
黑盒挑战:AI 存在"答案漂移"(同问题多次问答案不同)、黑盒推荐、多平台算法差异等痛点。
1. 白皮书引入的权威方法
白皮书引入了普林斯顿等机构在 KDD 2024 发表的权威论文方法(arXiv:2311.09735),量化了 9 种内容优化方法对 AI 引用率的影响:
头部高收益方法:
口径说明:以下数值与权重沿用原文引用的研究或平台资料,并非统一行业标准,也不是本站实验结果;使用前应核对其定义与样本。
| 方法 | 提升幅度 | 说明 |
|---|---|---|
| 引述添加 | +42.6% | 在内容中加入带引号的专家或客户原话。AI 偏好这种高信息密度的可复用片段 |
| 数据添加 | +32.8% | 内容中多包含具体数字、单位和时间 |
| 流畅度优化 | +28.7% | — |
| 引用来源 | +27.7% | — |
必须避免的反模式:
口径说明:以下数值与权重沿用原文引用的研究或平台资料,并非统一行业标准,也不是本站实验结果;使用前应核对其定义与样本。
| 方法 | 影响 | 说明 |
|---|---|---|
| 关键词堆砌 | -8.7% | 在同一段落内重复关键词 ≥5 次。AI 经对抗训练会识别为低质 Spam 并主动降权(与传统 SEO 关键词密度思维相反) |
其他痛点:句子过长(平均 >50 字)、空话堆砌(如"致力于/极致/赋能"等定性词过多)、纯口号无数据。
2. 九维 GEO 指数体系
为精确评估品牌的 GEO 现状,平台设计了九维加权评分,并根据不同行业(如律所重信源、餐饮重情感)动态调整权重:
口径说明:以下数值与权重沿用原文引用的研究或平台资料,并非统一行业标准,也不是本站实验结果;使用前应核对其定义与样本。
| 维度 | 默认权重 | 说明 |
|---|---|---|
| 提及率 | 20% | 全部样本中 AI 提到品牌的比例(入门门票,没它后面都没意义) |
| 推荐位排名 | 12% | 列表型回答中品牌排第几位(第 1 与第 5 转化率差 5-10 倍) |
| 引用强度 | 12% | 强引用(首选推荐)vs 弱提及(列在长清单里) |
| 稳定性 | 12% | 多次采样间的波动反比(AI 存在答案漂移,需多次采样看滚动窗) |
| 情感正向率 | 10% | 被提及内容中正向语义的比例(负向提及是品牌资产损耗) |
| 平台覆盖率 | 10% | 6 大主流 AI 平台中提到了几个(防流量过于集中和脆弱) |
| 直接命中率 | 8% | 实体名原样出现 vs 间接指代(直接命中是最强引用证据) |
| 自有信源被引率 | 8% | AI 引用来源 URL 中企业官网等自有信源的占比 |
| 联网引用率 | 8% | AI 回答附带外部链接的比例 |
最终得分对应 S(85+)、A(70-85)、B(55-70)、C(35-55)、D(<35)五个评级。低于 35 分为 D 级,急需建立基线。
3. GEO 运营 30 天落地闭环指南
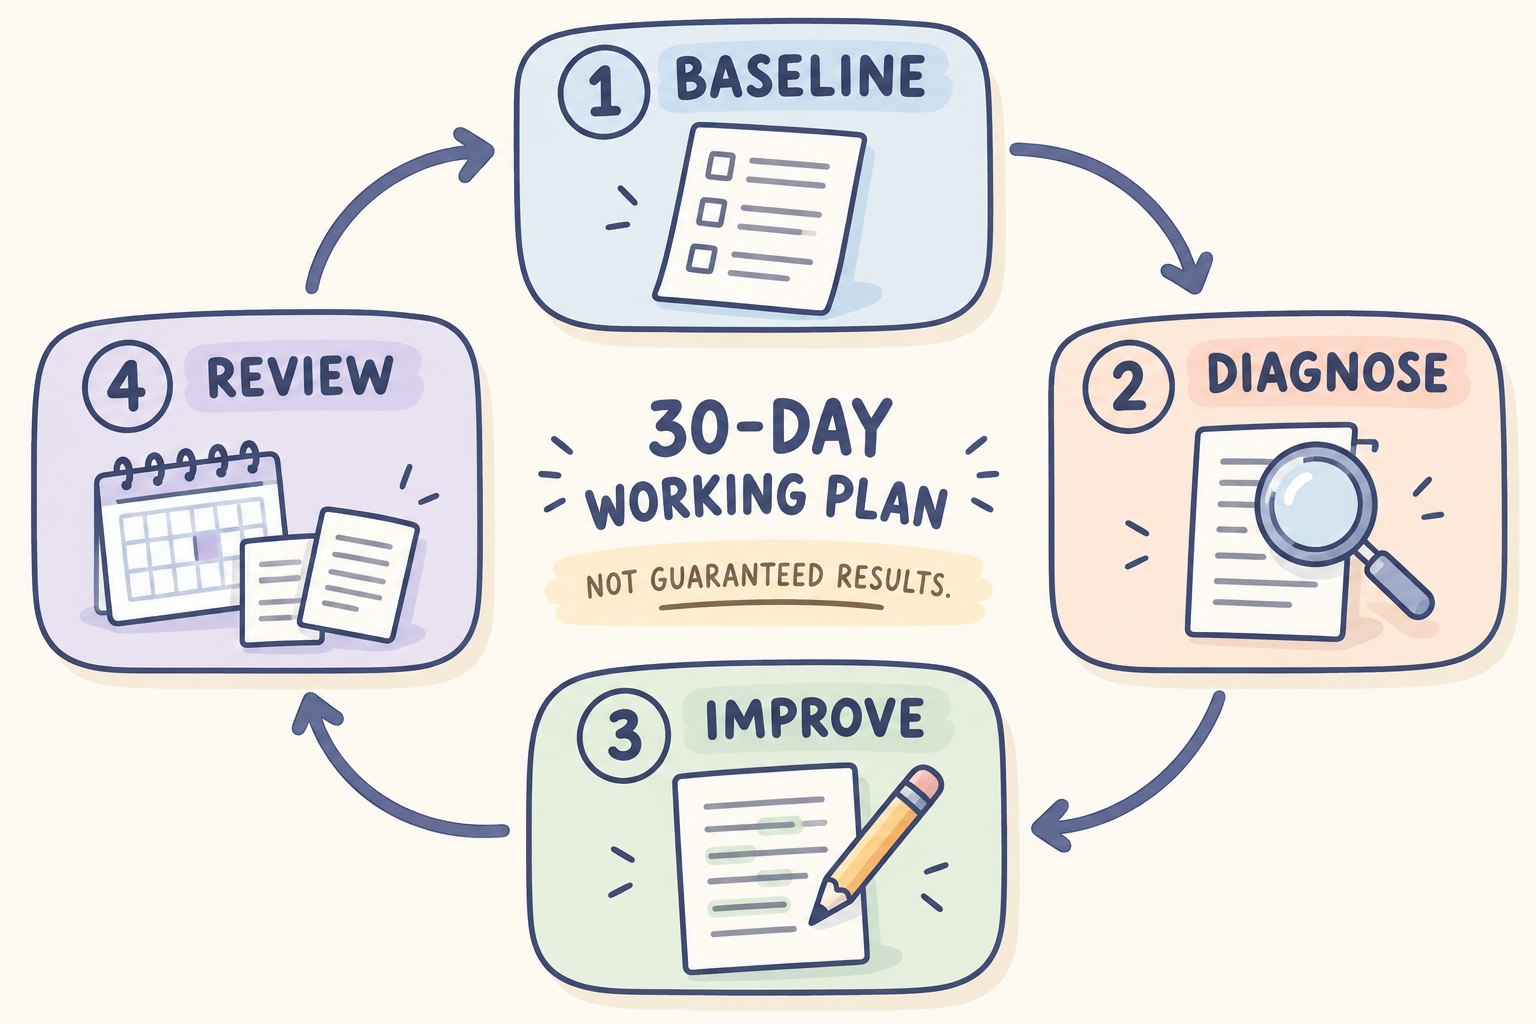
GEO 是一个包含监测、诊断、生产、发布、追踪、反哺的完整闭环:
第 1 周:基线监测与真相档案
录入企业的"真相档案"(成立时间、主营、核心团队、客户名单、资质等)。利用 Query Fanout 25 矩阵,将 1 个核心查询扩散为覆盖客户全决策旅程(认知、对比、验证、避坑、价格)的 25 个变体,并建立初始评级。
第 2 周:诊断与优先级排序
开启反模式雷达,扫描官网及现有内容。运行品牌误解识别:检查 AI 是否"说错"你(如时间、资质错误),按 High/Medium/Low 严重级即时拦截或在后续内容中纠偏。找出与竞品的 Gap 查询(竞品独占的搜索词)。
第 3 周:内容精准生产
针对 Gap 查询,利用平台生成器产出 5-8 篇优化内容(融入数据、引述,并自动附带 Schema.org JSON-LD 结构化代码,如 Organization、Article、FAQPage 等)。
第 4 周:多平台适配发布与追踪
拒绝一键群发:同一主稿必须根据微信公众号(严肃专业)、知乎(问句+案例)、小红书(emoji+短句)等不同平台的算法规则进行独立适配,否则会被平台整体降权。发布后在 D+7、D+14、D+28 自动复测,追踪 Before/After Lift(提升曲线),用数据反哺下一轮选题。
4. 技术壁垒:分布式真实节点采样
采样设计需要区分 API 与产品界面的实际差异,记录模型、联网状态和时间;不能预设 API 一定是降级模型。以下保留平台方案中的分析思路,不把供应商描述当成独立验证结果。
- 浏览器界面采样:在有权访问的页面记录实际展示结果;测试环境与条件保持可追溯,不把共享登录凭据或绕过风控作为 GEO 方法。
- 双层语义判定:先进行规则粗筛(字符串/别名/同名歧义过滤),再由 LLM 判定具体的位置、情感与置信度,低置信度(<0.5)扣减分数防止虚高。
- 句子级引用检查:保留答案已有的引用标记,并核对来源是否支持相应句子。仅按句号拆分或语义相似,不能证明一句话来自某个 URL。
- 多模态采样取证:每次采样自动留存 1-3 分钟录屏(存腾讯云 COS)、关键截图和原文,便于回溯和向客户演示。
参考链接
迁移校注与补充资料
Google 的 AI 搜索功能文档说明,现有 SEO 基础仍然适用,无需特殊的 AI 专用结构化数据。其内容质量文档也明确,E-E-A-T 本身不是一个具体排名因子。这些说明适用于 Google 的公开文档,不能直接代替其他服务的实现说明。