复制文章时自动带上来源:给 Hexo 博客加一行版权声明
把博客仓库改成私有之后,源工程不再对外公开,但网页上的文章仍然可以正常选中和复制。
我希望读者复制一段内容时,能顺手带上原文地址。提示不用很长,也不想让复制一条命令变得麻烦。最终在复制内容末尾追加的是这一行:
1 | 来源:Billy 的博客|原文:https://iowill.com/blog/当前文章/|转载请注明出处 |
这项功能通常叫“复制自动追加版权声明”或“复制来源标注”。这次是在 Hexo 8.1.2、Butterfly 5.7.0 的现有博客上修改主题原生功能,已经做过浏览器真实剪贴板测试,并在正式域名验证了复制结果。
先确定哪些内容应该追加
最直接的做法是监听整个页面的复制事件,然后给所有内容都加上声明。但博客里还有短命令、配置文件和完整代码块,这些内容往往要直接粘贴到终端或编辑器里。
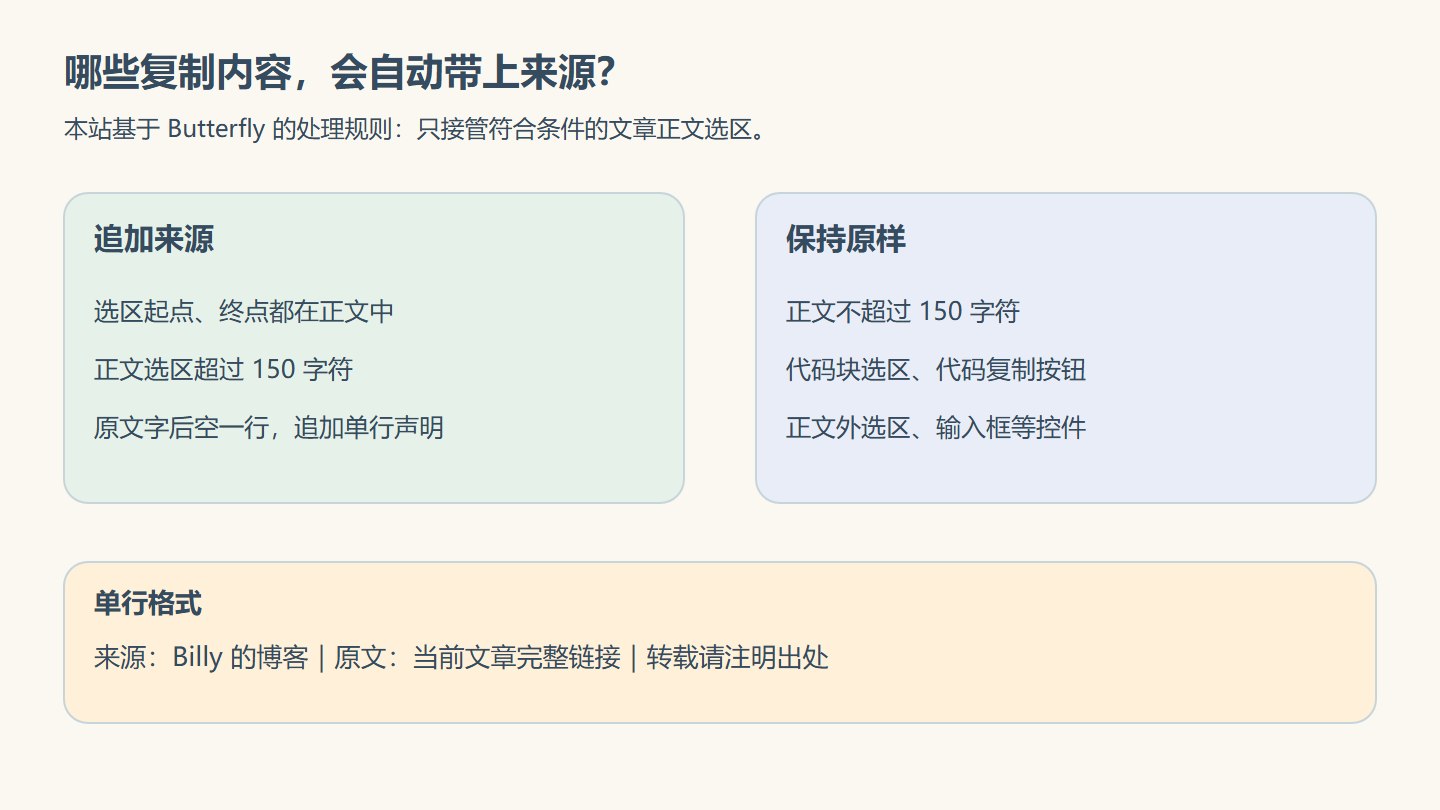
所以这次的规则是:
| 复制场景 | 处理方式 |
|---|---|
| 文章正文,超过150字符 | 原文后空一行,追加单行来源 |
| 文章正文,不超过150字符 | 保持浏览器默认复制 |
| 代码块内选中复制 | 不追加 |
| 代码块工具栏的复制按钮 | 不追加 |
| 导航、侧栏等正文外内容 | 不追加 |
| 输入框或可编辑控件 | 不主动接管复制 |
来源链接指向当前文章,而不是固定首页。文章底部已有的许可说明也保留,不用这一行转载提示去替换完整的许可信息。
开启 Butterfly 自带的复制版权功能
Butterfly 已经提供复制版权配置,不需要先安装另一个剪贴板插件。主题配置文档中可以查到相关开关。
本站使用独立主题配置文件 hexo/_config.butterfly.yml:
1 | copy: |
这里的 limit_count 是追加声明的长度阈值。本站代码使用 copyFont.length > limitCount 的逻辑,恰好150不追加,从151开始追加。
开启配置只是启用原生机制。默认输出格式和作用范围仍要看当前主题代码,不能以为改了开关就自动变成上面的单行样式。
这次相关的源文件有三个:
| 文件 | 作用 |
|---|---|
hexo/_config.butterfly.yml |
启用功能、设置阈值和脚本版本 |
hexo/themes/butterfly/layout/includes/head/config.pug |
将配置和提示文字传给前端 |
hexo/themes/butterfly/source/js/main.js |
在复制时检查选区并写入剪贴板 |
这些是本站保存在仓库中的主题源文件。其他项目的主题可能通过 npm 安装,或者目录结构不同,要先确认自己的维护入口;不要直接修改生成目录或依赖缓存。
将默认多行声明改成一行
原生模板会生成 GLOBAL_CONFIG.copyright,其中包含长度阈值和文案。本站保留了原有对象结构,只调整其中两项:
1 | languages: { |
这是 config.pug 中服务端配置对象的一部分,并不是让浏览器直接执行 _p()。它仍经过原有的 JSON.stringify() 流程输出到页面。
随后在主题现有的 addCopyright() 中拼出最终文案:
1 | const textFont = `${copyFont}\n\n${languages.source}|原文:${url}|${languages.info}` |
两个换行让来源与复制的正文分开,声明自身保持一行。config.title 读取站点标题,当前就是“Billy 的博客”,不需要在多个页面手工重复填写。
下面的修改应替换现有处理逻辑,不要另外叠加第二个全局复制监听器,否则容易出现重复追加或事件互相覆盖。
只接管符合条件的正文选区
关键不在拼接字符串,而在决定什么时候接管复制。本站现有 handleCopy 调整为:
1 | const handleCopy = e => { |
这段处理仍放在主题已有的 addCopyright() 作用域里,沿用前面解构得到的 limitCount 和 languages,以及原有的事件注册:
1 | document.body.addEventListener('copy', handleCopy) |
前面的几个 return 都不会阻止默认复制。只有选区和长度满足条件,才调用 preventDefault(),把加上来源后的文本写入剪贴板。copy 事件中修改写入内容的机制,可以参考 MDN copy 事件文档。
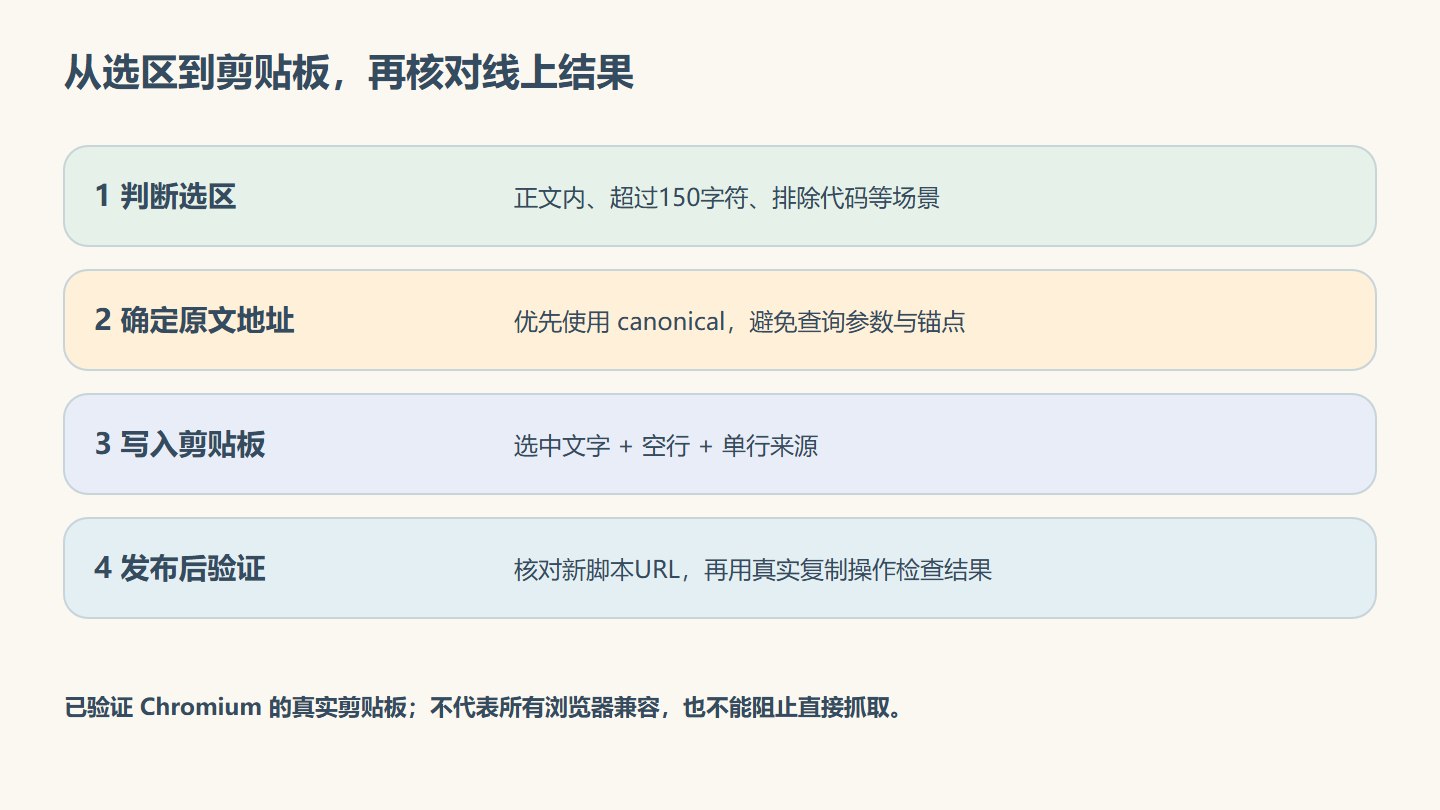
选区的起点和终点都需要落在 #article-container 内;完全处在同一个代码块中的选区则跳过。这样复制整段配置时,不会在末尾混入一行无法执行的转载提示。
代码工具栏另有一条路径:这个版本的 Butterfly 使用 navigator.clipboard.writeText() 直接写入代码。本站没有给这条路径追加声明,并用实际按钮点击验证了结果。MDN writeText 文档说明了这个接口;浏览器权限与安全上下文要求也应在测试时考虑。
原文地址为什么取 canonical
如果直接使用 window.location.href,来源可能带上查询参数、文章锚点,或者变成 www 域名下的地址。
本站文章已有指向 https://iowill.com/ 的 canonical,因此优先从页面读取:
1 | const url = document.querySelector('link[rel="canonical"]')?.href |
这沿用了网站自己的正式地址约定。即使从其他入口打开文章,复制出处也能落到统一链接。页面没有 canonical 时才退回当前地址,因此发布前仍要检查 canonical 本身正确,不能把错误的配置当成可靠来源。
测试时真的按一次复制键
只检查配置值或者调用字符串拼接函数,无法证明浏览器实际复制的结果正确。
本站使用 Playwright 启动 Chromium,给测试上下文授予剪贴板读写权限,打开已经生成的文章页面。在页面中建立选区后,执行:
1 | page.keyboard.press('Control+c') |
本地回归通过的项目包括:
- 151字符正文,完整结果等于“选中内容 + 空行 + 指定来源行”。
- 150字符正文,不追加。
- 200字符代码块和正文外选区,不追加。
- 原生代码复制按钮能复制内容,结果里没有来源行。
- 测试页面带查询参数和锚点,追加的地址仍使用文章 canonical。
这部分回归位于 hexo/bin/test_copy_copyright.py,使用构建产物启动本地 HTTP 服务,不向线上文章注入测试内容。
上线后又在正式域名的现有文章中选取多段真实正文,实际复制并读取剪贴板,核对了整段文字与来源行,结果符合预期。
验证范围也要说清:这次确认的是 Chromium 中的复制结果,并没有把它扩大成所有手机浏览器、阅读器或富文本应用都已测试。当前接管的长文本复制写入的是纯文本,粘贴到不同应用后的呈现仍可能不同。
发布后,确认页面加载的是新脚本
代码改完后还有一个常见误区:页面已经更新,浏览器拿到的 main.js 却仍是缓存版本。
本站给主题脚本的引用增加了版本参数:
1 | CDN: |
这是配置片段,应合并到原有 CDN.option,不要覆盖其他脚本配置。
随后按本站流程构建、校验、备份发布,再推送由 Cloudflare Pages 构建。最终检查的不只是源文件,而是线上 HTML 是否真的引用了带版本参数的脚本,以及实际剪贴板内容是否变化。
这次发布对应提交 2656be77,Cloudflare 部署成功后,正式域名的复制测试也通过。文章正文、原始发布日期和底部许可没有因这项功能而被改写。
它能留下来源,但不能锁住内容
这行声明适合让普通复制带上出处,尤其是把一段说明转发到笔记或聊天时,别人还可以回到原文查看完整上下文。
但对方可以删掉声明,采集程序也可以直接读取 HTML,不触发浏览器里的复制事件。它不能证明站点已经防住整站镜像,也没有替代文章原有许可、图片水印或服务端流量防护。
对技术博客来说,我更看重的是把来源信息补得恰当:复制较长正文时带上链接,复制命令和代码时保持干净。功能是否实现,可以通过真实剪贴板检查;是否从此无人搬运,则不能由这一行文字保证。