CDN 会误拦 AI Search 吗?从 WAF 规则到抓取日志排查
会发生与站长期望不一致的拦截,但“AI 没有引用我的网站”不足以证明 CDN 误拦。 需要确认请求是否真的发出、是谁发出的、命中了哪条规则,以及返回的是正文还是验证页面。
CDN 负责分发内容,WAF 与机器人防护负责按规则处理请求。同一平台把这些能力放在一起,不代表每一次访问失败都由同一个功能引起。连接超时、源站报错、主动禁止训练抓取和规则误判,需要分别判断。
本文面向使用 CDN 的博客维护者,以 Cloudflare 为主要配置背景,资料核对日期为 2026 年 10 月 30 日。内容是官方机制与排查方法整理,没有取得足以确认本站 AI 搜索请求被误拦的完整日志,也没有对本站执行防护规则变更。文中的命令、条件示例不代表官方机器人实测结果。
搜索抓取、用户读取与训练抓取的区别
允许搜索发现网站,同时限制训练用途,是可以分别表达的内容策略。机器人名称与用途应查对应服务的官方资料,不宜把带有“AI”的请求全部归为一类。
| 服务标识 | 官方说明的主要用途 | 排查时关注什么 |
|---|---|---|
| OAI-SearchBot | ChatGPT 搜索相关抓取 | 搜索访问策略与对应来源范围 |
| GPTBot | 可能用于基础模型训练的内容抓取 | 是否符合站长的训练用途政策 |
| ChatGPT-User | 某些由用户操作触发的页面访问 | 不等于自动搜索抓取,robots规则可能不适用 |
| PerplexityBot | 帮助网站出现在 Perplexity 搜索结果中 | 机器人自己的来源范围与访问策略 |
| Perplexity-User | 用户提问触发的页面读取 | 与自动抓取分开核对,官方说明通常忽略robots规则 |
OpenAI 的机器人文档区分了搜索、训练与用户触发访问,并发布对应 IP 范围;Perplexity 的文档同样区分两类请求。表中的标识是用途线索,仅凭 User-Agent 字符串不能确认身份。
Cloudflare 的现行 AI 机器人策略文档列出 Search、Agent、Training 等行为分类,以及整站阻止、含广告页面阻止和不增加阻止的选项。兼具搜索与训练用途的抓取也需要按实际分类检查,不能由机器人名称自行推断。
旧教程中的单一“Block AI bots”开关不能概括全部现行设置。该文档同时包含旧选项与迁移说明;操作时应以账号实际控制台、套餐和已启用策略为准,不从一张旧截图推定本站当前配置。
误拦需要同时满足策略与请求证据
假设你希望某个经过验证的搜索机器人访问公开文章,但一条“阻止自动化访问”的自定义规则将它拒绝,这才是需要调查的策略冲突。若你本来就决定禁止该类请求,规则按预期阻止它,便不应仅因对方是 AI 服务而称为误拦。
这是判断方法示例,不是本站事故记录。需要核对的证据包括:
- 预期策略:允许哪种用途、哪些机器人、哪些公开路径。
- 实际请求:时间、主机名、路径、来源身份和请求标识能否对应。
- 处理结果:命中规则、动作与返回内容是否符合预期。
- 复测差异:有限调整后,同类请求是否取得完整正文。
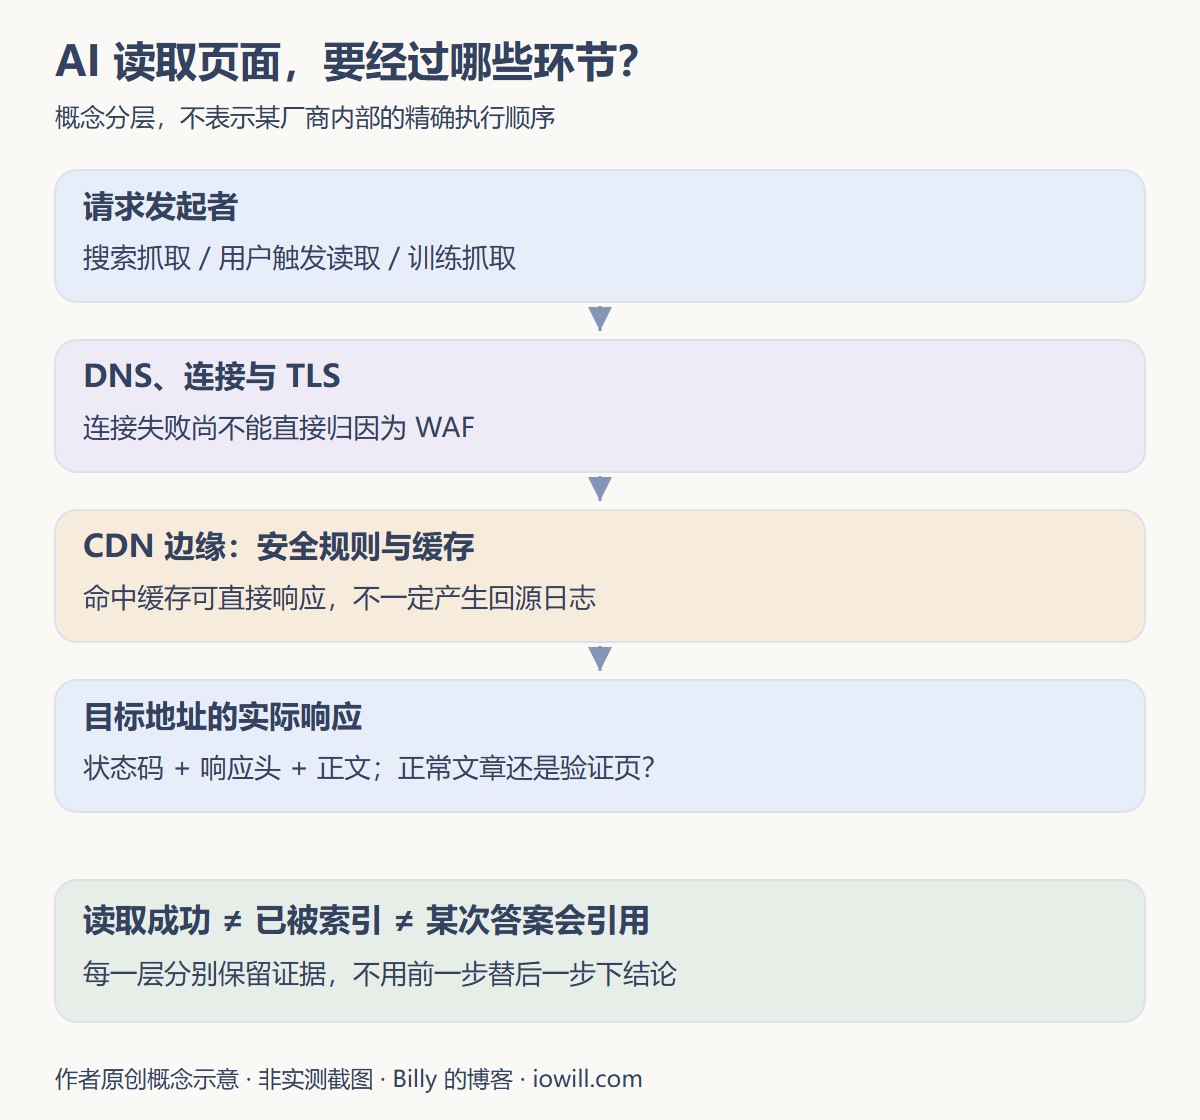
CDN 缓存命中时,请求可能直接由边缘响应,源站没有对应访问日志不等于被拦截。反过来,源站收到请求,也不证明最终传给读取工具的是可用正文。应把边缘与源站记录放到同一次请求链路中检查。
HTTP 状态、挑战页面与连接错误的判断
| 观察结果 | 可以先确认什么 | 仍需核对什么 |
|---|---|---|
| DNS、TCP 或 TLS 阶段失败 | 尚未拿到正常 HTTP 响应 | 网络路径、解析与连接;不能直接认定WAF拦截 |
| 403 | 访问被拒绝 | 是边缘规则、源站权限还是其他服务返回 |
| 429 | 请求遇到限流类响应 | 哪一层限流、阈值与请求频率是否对应 |
| 5xx | 链路或服务出现错误 | 边缘与源站各自的状态、事件和可用性 |
| 200,但内容为验证页、登录页或空壳 | 传输成功不等于文章可读 | 最终正文、跳转链路、渲染和访问前提 |
Cloudflare 对其 Challenge Page 提供明确标识:响应头中出现 cf-mitigated: challenge,响应类型为 text/html。官方检测说明支持用该字段识别此类挑战。
这个标识用于 Cloudflare 的挑战页,不是所有拦截的统一标志。没有它,不能反推“绝对没有WAF处理”;同样,Content-Type: text/html 本身也不能区分正常文章和验证页。
用 GET 保存响应头与正文
在 Linux / macOS shell 中,可对自己管理的公开文章执行一次低频检查。Windows PowerShell 中使用 curl.exe,避免命令别名差异。将示例域名与路径替换为目标地址:
1 | curl --connect-timeout 10 --max-time 30 \ |
文件保存在当前目录。检查响应头中的状态、Content-Type、Location、CF-Ray 与 cf-mitigated,再打开 response.html 查看实际内容。仅运行 HEAD 请求不能检查正文;本例也不把所有非200状态一概当成失败原因。
本命令没有自动跟随跳转。若收到3xx,核对 Location 后继续检查最终地址,并保留前后响应;不要把第一跳正常当成最终文章正常。普通 curl 成功,只能说明这次请求路径可用,不能代替其他服务出口的结果。
需要比较 UA 条件时,可以另存一组响应:
1 | curl --connect-timeout 10 --max-time 30 \ |
这是手动修改请求头的模拟请求,不是真实 OAI-SearchBot。 它最多帮助发现按UA字符串处理的差异,不能验证官方来源身份,也不能据此创建仅凭UA放行的安全例外。两次结果还可能受时间、缓存或请求频率影响,需要继续关联日志。两条命令的响应保存方式已在本地模拟HTTP服务中核验,覆盖普通正文、按UA返回模拟挑战和保留跳转;这不验证真实Cloudflare规则或官方机器人。
在安全事件中核对具体规则
Cloudflare 的Security Events用于查看被安全产品处理或标记的请求,不是所有访问的完整流水。其日志可能采样;一个请求也可能对应多条安全事件。因此,列表没有命中项,并不能单独证明请求没有到达。
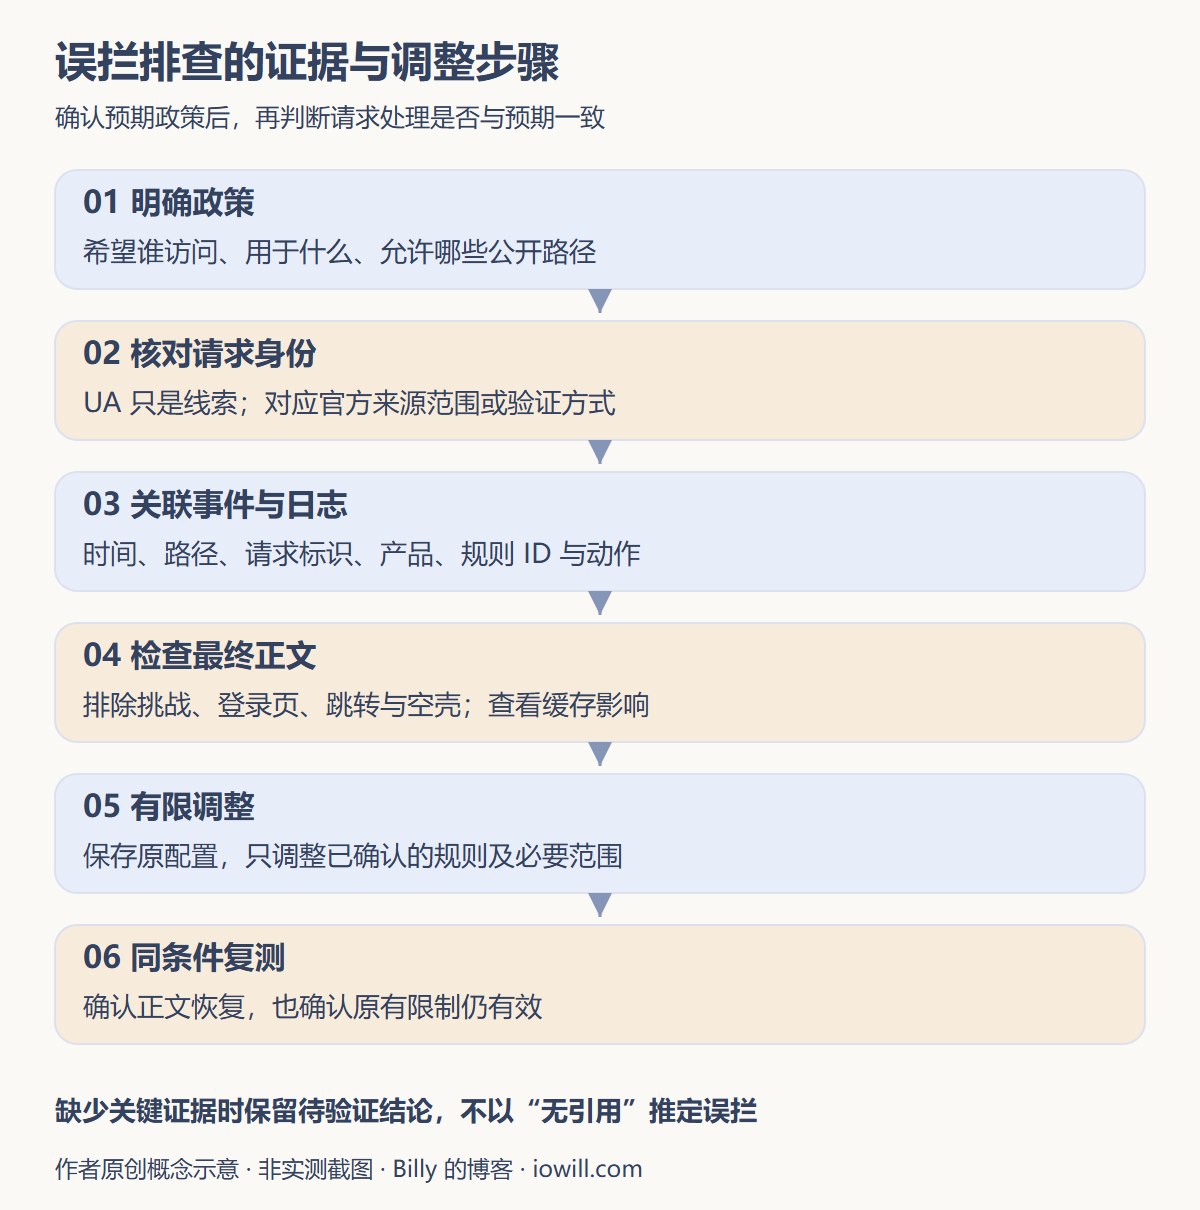
排查时,我会按以下顺序缩小范围:
- 统一发生时间和时区,确认主机名、原始路径及最终跳转地址。
- 用请求标识、路径、来源等条件定位事件,记录实际产品、规则ID与动作。
- 对照服务商公开来源范围或其支持的身份验证方式,不把控制台中的机器人名称当作唯一证据。
- 查看源站或托管平台日志,同时检查缓存命中,避免把“未回源”误判为“被挡住”。
- 如果日志缺失,检查查询窗口、采样与套餐能力;证据不足时保留待验证结论。
AI Crawl Control 的管理文档还说明,面板中的失败请求可能来自其他规则或响应错误;免费套餐中的相关识别依赖UA字符串。运营统计中的分类与安全放行所需的身份依据,应分别判断。
可用这张表保存证据,空项写“未取得”,不要按猜测补齐:
| 证据项 | 建议记录内容 |
|---|---|
| 时间与目标 | 含时区的时间、主机名、路径和跳转链路 |
| 请求身份 | UA、官方来源核对方式及结果 |
| 边缘处理 | 请求标识、命中产品、规则ID、动作、缓存信息 |
| 实际响应 | 状态、关键响应头、正文是否为目标文章 |
| 源站情况 | 是否收到对应请求、返回结果与日志范围 |
| 变更与复测 | 原规则、有限调整、恢复办法及同条件结果 |
公开案例时应脱敏账号、凭据、不必要的真实来源地址和后台信息。本文没有把这张待填写表当成已发生的日志。
Allow 与 Skip 的作用范围
在 AI Crawl Control 中选择 Allow,不代表请求自动绕过其他WAF规则。Cloudflare 的产品交互文档明确讨论了这种情况:允许的机器人仍可能被更早执行的自定义规则阻止。
调整应针对已经确认的规则和请求范围。我的建议是:
- 保存原规则、优先级和相关开关,确定可以恢复的配置。
- 明确目标机器人与用途,使用其对应的当前官方来源范围或平台支持的验证方式;不要混用不同机器人的地址列表。
- 只为需要公开的主机、路径和请求方式设置必要例外,不把后台或其他接口一并放开。
- 核对命中规则属于哪个阶段,再决定修改条件或使用适当的跳过能力。
- 复测目标请求,也检查原本需要限制的请求仍受到限制。
Cloudflare 的 Skip 文档说明,它可以跳过部分安全功能,但不能跳过 Bot Fight Mode。不要把它与 Super Bot Fight Mode 混为一谈;勾选哪些功能、规则顺序与套餐能力都影响实际结果。
Perplexity 的官方配置示例还要求各机器人分别匹配自己的来源范围,并指出 Skip 只作用于其后执行的相应规则。与其复制一条“包含某名称就放行”的宽泛规则,更应先找出真实命中的产品与阶段。
这些是调整方法,不是要求关闭全站防护。本篇发布不包含对本站WAF、机器人开关或访问策略的修改。
robots.txt、索引与最终引用分别验证
robots.txt 表达抓取偏好,不是访问授权机制。RFC 9309明确区分了这两件事:允许抓取不等于WAF必须放行,写入Disallow也不是保护私有数据的权限控制。
例如,下列片段只演示“允许某搜索抓取、限制某训练抓取”的区别,不是本站现行配置;使用时需与已有规则合并核对:
1 | User-agent: OAI-SearchBot |
这两组设置不替代其他产品的策略。用户触发的读取还要按服务各自说明判断,不能假定所有请求都以相同方式处理robots规则。更新文件后,也不能期待所有抓取系统立即重新访问。
恢复访问后的验收应分层记录:
- 连接与响应:请求到达,取得目标地址的正常响应。
- 正文读取:返回内容包含可读标题、主体和必要上下文。
- 索引状态:相关搜索系统是否已经处理该页面。
- 答案引用:在具体问题、时间与产品下,是否出现准确引用。
Google 对AI Overviews 与 AI Mode 的官方说明要求页面已被索引且具备在搜索中显示摘要的资格,同时强调符合要求也不保证抓取、索引或展示。这是Google搜索的适用条件,不能扩展为所有AI产品的统一规则。
因此,CDN排查的直接目标是:找到与预期不符的处理,恢复必要的正文访问,并留下复测证据。后续是否进入索引、被哪一次回答引用,需要另外观察;开启某个开关不是引用率承诺。
关于内容被引用后的信源分布,可继续阅读拆解GEO信源生态与集中度;内容导览文件的作用与限制见llms.txt文章。这些内容入口不能替代访问链路的核验。
参考资料
资料于2026年10月30日核对。以下为官方产品文档与标准;它们支持各自的机制说明,不代表独立复现了本站误拦,也不把同一厂商的多页文档当成多次独立效果验证。
- OpenAI:Overview of OpenAI Crawlers,搜索、训练与用户触发访问的区别。
- Perplexity:Perplexity Crawlers,用途、来源范围与WAF配置边界。
- Cloudflare:Block AI Bots,行为分类、选项及旧设置迁移说明。
- Cloudflare:Manage AI crawlers,面板识别、统计与管理动作。
- Cloudflare:Detect a Challenge Page response,挑战响应标识。
- Cloudflare:Security Events,事件范围、采样与字段。
- Cloudflare:AI Crawl Control with Cloudflare WAF,执行顺序与Allow仍被拦的情况。
- Cloudflare:Configure a custom rule with the Skip action,跳过范围与Bot Fight Mode限制。
- RFC 9309:Robots Exclusion Protocol,robots规则及非授权属性。
- Google:AI features and your website,Google AI搜索的资格与不保证展示的边界。