快手 Web Cookie 与会话管理实践:跨页面登录状态异常排查
最初,这看起来只是一个 Cookie 导入问题:浏览器正常打开,文本没有解析报错,页面却仍然显示未登录。更换为主站登录后的 Cookie,账号能够进入;但在多账号切换、直播访问和跨页面任务中,登录状态又出现了不一致。
Cookie 导入成功、浏览器带出 Cookie、目标页面确认登录,以及登录的是所选账号,是四个需要分别核对的结果。 任何一步成功,都不能替后面的步骤作保证。
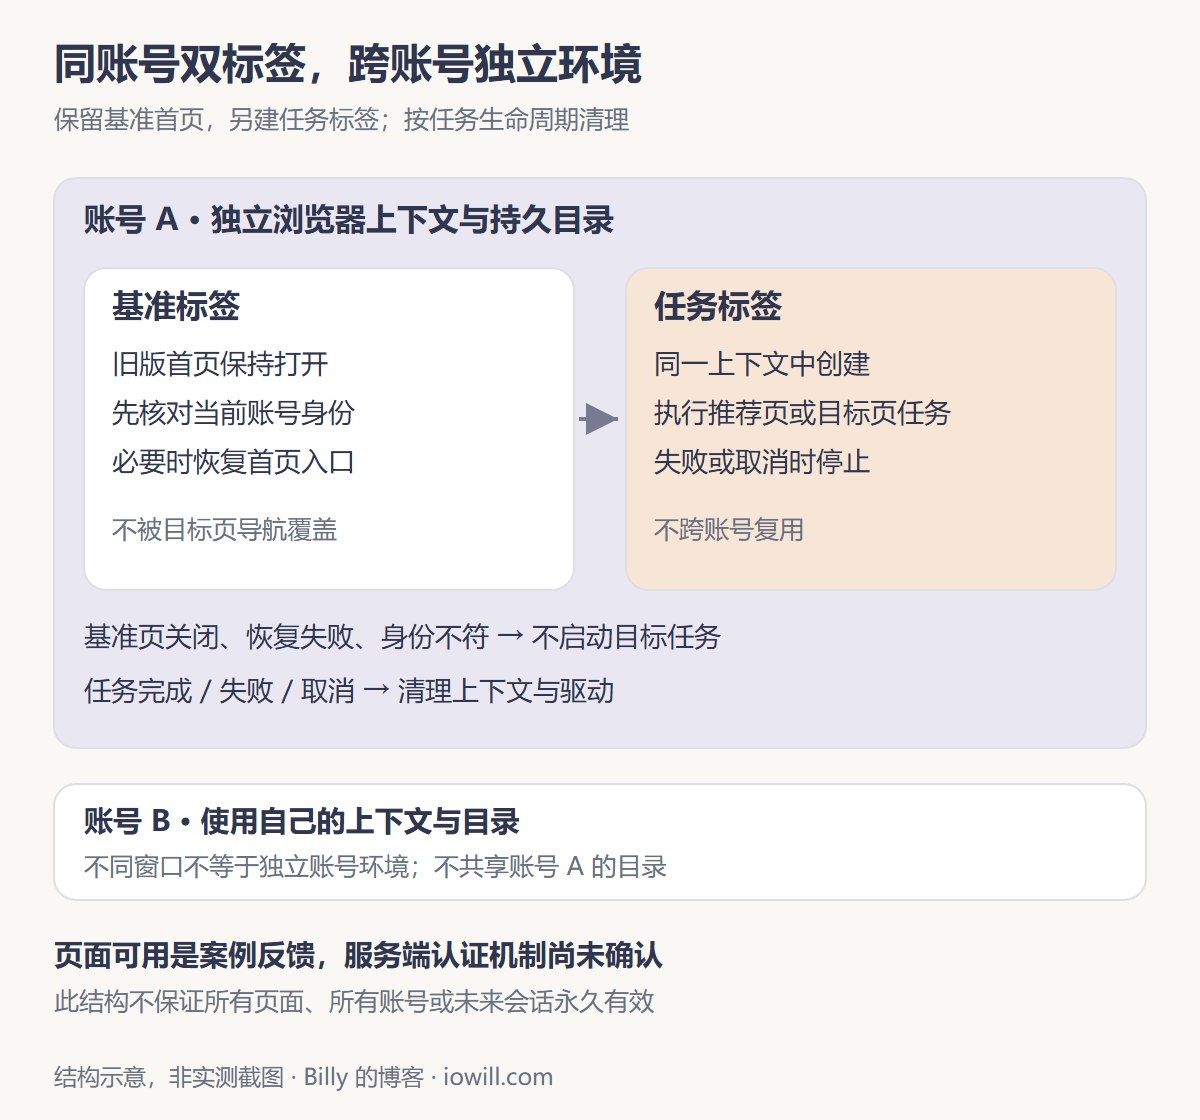
后续实际使用反馈带来了关键变化:保持已登录的旧版首页打开,再在同一浏览器会话的新标签中访问新版推荐页、直播和创作者中心,该次测试均可正常保持登录。 因此,ksDM 将浏览器任务拆成保留的基准首页和单独的任务标签。
本文记录这一排查过程及其工程实现。跨页面访问结果来自开发中的实际使用反馈;代码说明依据作者私有项目 ksDM 的固定版本(提交 352bc24),源码与开发记录未公开,读者无法通过公开仓库独立复核项目实现。本次成文在本地核对了该版本与通用文档,没有重新使用真实账号进行线上实验,也没有确认快手服务端的完整认证机制。
问题起点:Cookie 来源与访问目标不一致
早期样本复制自快手创作者服务平台,自动化访问的却是主站。该样本导入后,主站依然显示未登录;更换为主站正常登录后的请求 Cookie,开发中反馈可以登录。这段过程已记录在快手与抖音 Cookie 获取和使用差异案例。
当时还观察到 HTTP 200 与业务响应 {"result":109} 同时出现。可以确认的是该样本未恢复目标主站登录,不能仅凭 HTTP 200 宣告成功,也不能把 109 当成所有快手业务统一的 Cookie 过期码。
到了后续阶段,观察条件发生了变化:起点是已经建立登录的浏览器会话,旧版首页持续打开,其他页面在同一会话的新标签中访问。
| 场景 | 观察结果 | 能支持的结论 |
|---|---|---|
| 早期创作者平台样本直接导入主站 | 主站未登录 | 该样本、该流程没有恢复主站登录 |
| 更换主站正常登录后的样本 | 主站登录成功 | 该次主站验证通过,其他任务仍需分别检查 |
| 后续保留已登录首页,同会话新标签访问 | 反馈新版推荐页、直播和创作者中心正常 | 该会话及访问条件下,已测试页面可用 |
这些观察不矛盾。复制凭据的方向、已有状态和访问过程不同,不能混写成一次“所有页面通用性测试”。尤其不能把第三行改写为“任意主站 Cookie 文本都能直接登录所有子站”。
跨页面结果记录:按页面列出反馈与证据缺口
下面将2026年10月26日详细素材记录的后续使用反馈拆开列出。共同条件为:旧版首页已经登录并保持打开,目标页在同一浏览器会话的新标签中访问。这是对已有反馈的整理,不是本次重新执行的逐页验收。
| 目标页面 | 素材记载的访问结果 | 当前可提供的依据 | 尚缺少的验证信息 |
|---|---|---|---|
| 新版推荐页 | 正常保持登录 | 开发中的实际使用反馈 | 本轮对应的账号状态响应与逐页截图 |
| 直播页面 | 正常保持登录 | 开发中的实际使用反馈 | 本轮最终页面路径与账号状态响应 |
| 创作者中心 | 正常保持登录 | 开发中的实际使用反馈 | 本轮账号状态响应及跨业务跳转记录 |
现有素材没有完整列出这次跨页面观察的账号数量、浏览器版本与逐页测试时间,因此不补造这些字段,也不计算成功率。这张表让读者看到反馈覆盖哪些页面,以及哪些证据仍未提供;它不能证明保留首页一定是成功的唯一原因。
Cookie 请求头为什么不等于完整浏览器会话
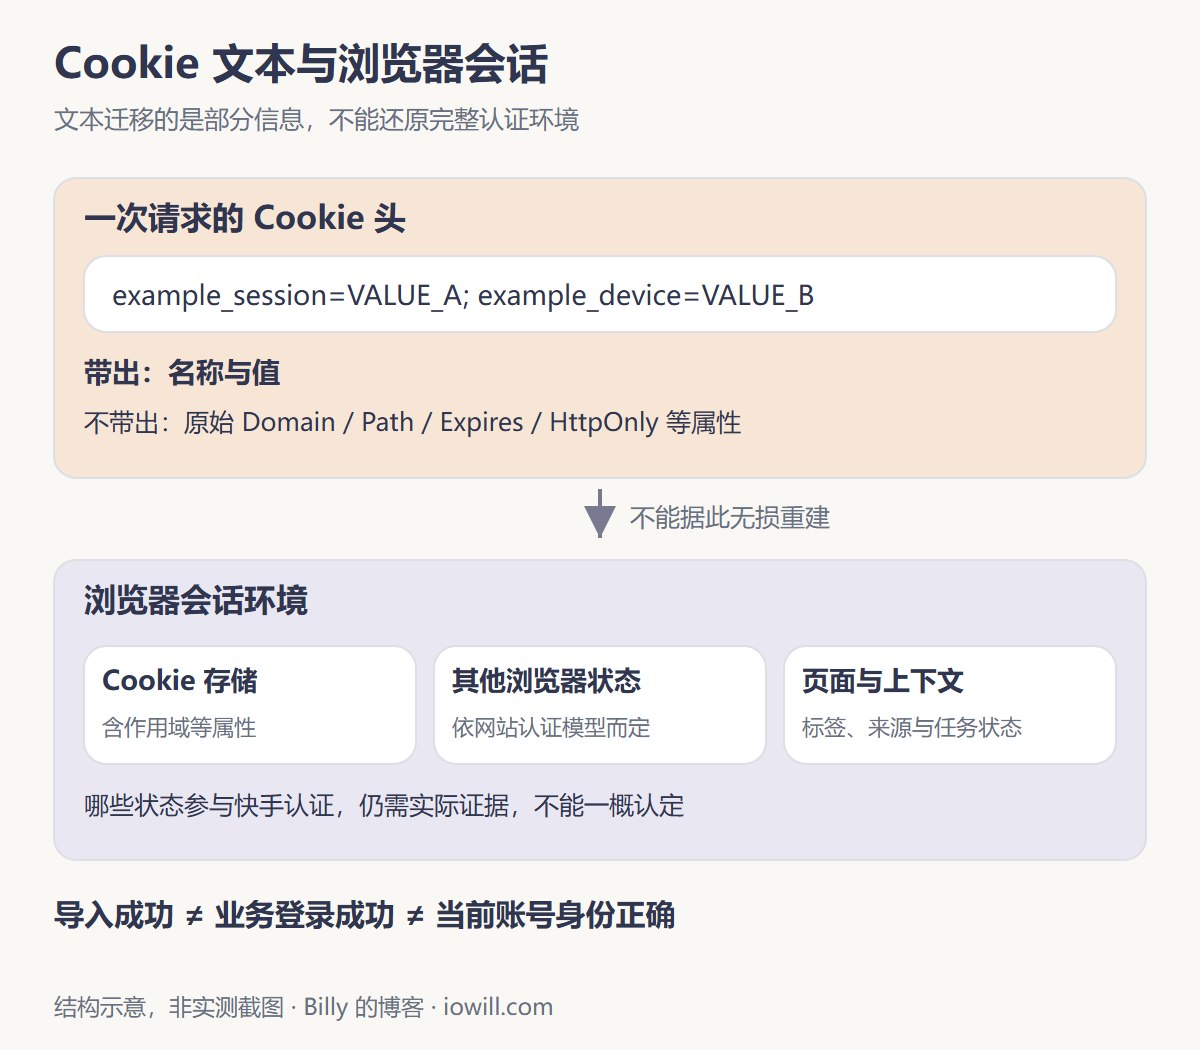
开发者工具中复制的 Cookie 请求头,通常是一串名称和值:
1 | Cookie: session_example=VALUE_A; device_example=VALUE_B |
以上名称和值均为虚构。这样的文本不包含原始 Domain、Path、Expires、HttpOnly 等存储属性。浏览器先按照适用规则选择 Cookie,再将名称和值写入请求头;复制这段文本,无法反推出完整的原始存储记录。MDN解释了 Cookie 的发送范围与访问限制。
同名 Cookie 尤其容易被忽略。不同 Domain 或 Path 下可能存在同名项;RFC 6265 §4.2明确指出,请求头不会携带那些存储属性,服务端也不应依赖同名项的序列顺序。
本次核对的 ksDM 有一个应当公开说明的边界:保存捕获文本时保留原文,但重新导入文本的 browser_cookies 按名称构建字典,后出现的同名项覆盖前项,并补充 .kuaishou.com 和 /。所以,原文保存与无损恢复原始 Cookie 存储,是两件事。 这描述的是当前客户端适配方式,不是快手规定的凭据格式。
浏览器认证还可能涉及其他状态。Playwright 认证文档列出了 Cookie、localStorage、IndexedDB 等认证状态,并单独讨论 sessionStorage。具体网站依赖什么,需要现场证据,不能把文档列举的存储全部说成快手已确认的登录依赖。
因此,Cookie 文本可以作为导入快照;账号持久浏览器目录用于复用浏览器状态。二者用途有交集,却不能互相替代。持久目录也不保证令牌永不过期、服务端永不撤销登录。
捕获实际请求,还要核对当前账号身份
排查时,Network 中出现过两条末段都叫 get 的请求:
1 | GET https://www.kuaishou.com/rest/v/profile/get |
这里省略了查询参数。它们不是同一个接口,也不能只凭列表中的 get 名称选择捕获对象。当前项目使用前者作为账号请求 Cookie 的捕获来源;后者没有承担这个角色。材料不足以进一步宣称后者永不鉴权,或永远不带 Cookie。
精确匹配请求,避免保存错误来源
RequestCookieSnapshot 在导航前安装到浏览器上下文,请求筛选条件包括 HTTPS、允许的主机、完整路径 /rest/v/profile/get 和 GET 方法,然后读取 request.header_value('cookie')。查询参数不参与路径匹配,不把某次请求的动态签名 URL 写死为长期入口。
Playwright Request API提供单个请求头的读取方法;普通 request.headers 不返回包括 Cookie 在内的部分安全相关请求头,不能据此直接判断浏览器没有发送 Cookie。页面脚本的 document.cookie 又受 HttpOnly 等约束,同样不等于完整导出。
当前实现每收到一个匹配请求,先清空旧捕获,再尝试读取。若最新匹配请求为空或读取失败,就不拿更早的值冒充最新结果;无关请求则不覆盖捕获。
空值有限重试,失败不覆盖原记录
如果完成身份确认和主页资料读取后,仍未捕获非空请求头,当前流程只刷新该账号主页一次,再有限等待延迟请求。代码中的导航上限为25秒,随后最多等待3秒、每200毫秒检查一次。这些是项目参数,不是平台要求。
刷新后还要重新核对快手号与主页 URL。未捕获、身份变化、读取失败或用户取消,都不能生成可保存的成功结果。2026-10-22的修改还移除了从 Cookie 库拼接字符串的导出兜底,避免将拼接结果冒充实际请求原文;这不表示 Cookie 库本身没有合法用途。
捕获非空请求头仍然只证明请求带了 Cookie。账号验证需要从当前账号入口进入自己的主页,读取昵称、快手号和主页地址,与所选账号对照。不能只取推荐卡片中的第一个头像,也不能仅凭 Cookie 中的 userId 判断身份。
多账号隔离:两个无痕窗口并不够
开发中曾遇到两个账号总有一个表现异常,随后发现 Cookie 来自同一 Chrome 中的不同无痕窗口。
Chrome 官方说明指出,在已有无痕窗口中再打开一个无痕窗口,会继续同一次无痕会话;需要关闭所有无痕窗口才结束它。因此,“两个窗口”不能作为“两个独立账号环境”的证据。
这能解释隔离方法为什么不可靠,却不能单独证明某次异常一定由另一个账号登录造成。还要检查取样时机、文本导入损失和服务端会话变化。
ksDM 为不同账号使用独立浏览器数据目录,新建账号或导入时先建立候选目录,验证身份后再提交为正式记录。昵称与备注用于显示,不决定目录归属;发现实际身份与预期不一致时停止任务。
Playwright 持久上下文文档说明,user_data_dir 保存 Cookie、localStorage 等会话数据,多个浏览器实例不能同时使用同一个用户数据目录。这里应使用独立的自动化目录,避免直接接管日常 Chrome 主配置目录。
已有账号复用时,也不应每次清空全部状态再注入旧文本。当前 restore_missing_cookies 只按规则补入缺失且适用的字段,不覆盖已有同名项,并跳过已过期项。这是恢复启发式规则,字段存在仍不代表服务端接受它,之后还须验证身份。
关键调整:保留基准首页,任务在新标签执行
2026-10-24的方案已要求先进入旧版首页核对身份,但后续导航仍可能在同一标签中覆盖首页。2026-10-26的实际使用反馈进一步指出:保持该首页登录并打开,在同一浏览器会话的新标签访问其他页面,结果正常。
本案例的旧版首页入口是:
1 | https://www.kuaishou.com/?isHome=1&source=NewReco |
于是,实现不再只改变初始 URL,而是明确分离两个标签的生命周期:
1 | 账号 A 的独立浏览器上下文 |
Playwright Pages 文档说明,一个 BrowserContext 可包含多个 Page。共享上下文让同账号标签使用相应浏览器环境,但不会让不同来源的全部存储无条件互通,也不会自动完成目标站点的业务认证。
基准页核对与任务页创建分别负责什么
enter_base_page 访问基准首页、读取当前账号入口,并与预期主页地址比较。new_task_tab 检查基准标签仍然存在,必要时恢复首页,再创建新的任务页。如果前面的入口交互已将基准标签带到个人主页,不能直接把该页当作仍在打开的首页。
基准页关闭、恢复失败、地址发生非预期跳转或用户取消时,不继续启动目标任务。恢复后的 URL 检查只是入口检查,不能写成“再次完整证明后台认证状态”。上述行为依据作者对私有项目固定版本 session.py 的本地核对。
保留标签的时间以任务生命周期为限
基准首页在任务运行期间保留。任务结束、失败或取消后,仍按原有清理逻辑关闭上下文及程序拥有的驱动;定时任务等待下一轮时,不因此永久挂着浏览器。
“打开主页”还需要以目标标签关闭作为结束条件,不能因为基准标签仍开着,就一直等待用户退出整个浏览器。双标签解决的是执行期间页面职责的组织,也必须同时处理退出行为。
这一做法在本案例下有可用性反馈,但底层原因尚未确定。站内认证衔接、页面初始化、本地状态更新或后台请求都只是候选解释。没有对照证据,不能声称首页周期性刷新了全站令牌,或关闭首页必然立即让其他页面退出登录。
按故障阶段排查,避免把超时都归为 Cookie 失效
在一次双账号任务里,一个账号在身份核对阶段超时,另一个继续执行推荐页检查。日志只能证明前者未能按时完成核对,不能直接改写为“Cookie 已过期”。同样,任务异常计数不等于失效账号计数。
脱敏日志:身份核对超时与后续任务进度
以下节选自详细素材保留的开发日志。账号显示名已替换为 A、B;片段保留原有时间与消息,不含 Cookie 值、账号 ID、头像地址或签名参数。素材未给出该片段的明确发生日期,不能把时分秒解释为2026年10月26日的实测时间。它属于较早的推荐页核对流程,也不是双标签方案的成功日志。
1 | 15:44:52 开始养号 · 2 个账号 |
片段可支持两个有限判断:账号 A 的流程在身份核对阶段报超时,账号 B 继续到了推荐页连播检查。它没有给出账号 A 的登录业务响应,不能由此确认凭据失效;账号 B 的补入消息也只说明程序报告执行了恢复动作,不能替代后续身份验证。
按层记录结果,再决定是否重新登录
可以按以下顺序保留证据,越过哪一层,就记录哪一层的实际结果:
| 排查层次 | 核对内容 | 结果应如何解释 |
|---|---|---|
| 浏览器启动 | 可执行文件、目录锁、权限与实际异常 | 未启动时,还没进入登录有效性判断 |
| 页面与网络 | 最终 URL、连接失败、挑战页、控件可操作性 | 超时可能来自不同环节,先定位阶段 |
| 凭据与请求 | 来源业务、目标请求、是否有非空 Cookie | 请求携带凭据不代表服务端认可 |
| 业务登录 | 账号响应与页面登录入口 | HTTP 200不能替代业务验证 |
| 身份一致性 | 当前主页与所选账号是否一致 | 不符就停止,不覆盖为成功记录 |
| 页面生命周期 | 基准页是否保留、目标页是否独立 | 记录操作条件,不直接推断服务端机制 |
诊断日志应保留任务、阶段、异常类型、脱敏后的路径,以及是否捕获 Cookie、是否通过身份核对等状态。依据本地核对的私有项目 diagnostics.py,当前实现也保存受限范围的失败页面材料,但没有自动截图。
不要把真实 Cookie 写入日志来证明已导入,完整签名 URL、账号标识、原始 DOM 和浏览器目录也不适合作为博客附件。自动脱敏之后,公开前仍需人工检查。
事后复盘:哪些结果可确认,哪些需要继续验证
此次工程调整最有价值的地方,是将保存、捕获、登录、身份和跨页面使用拆开验证,并将基准页与任务页分离。
证据也要按来源分开:
- 实际使用反馈:保留已登录旧版首页、同会话新标签访问时,该次测试的推荐页、直播和创作者中心正常。
- 固定版本代码检查:实现了请求筛选、有限重试、身份核对、独立目录和基准/任务双标签。
- 历史离线测试:开发记录包含账号验证、推荐页、主页监测与评论采集的离线检查,重点覆盖独立标签、失败停止和资源清理;这些不是本次成文重新运行的结果。
- 仍待验证的机制:首页是否触发了特定状态更新、关闭首页的影响及其时间尺度、跨重启表现,以及不同账号和业务入口的差异。
历史测试使用临时目录、虚构账号与请求拦截,可以检查是否创建两个标签、失败时是否停止、退出时是否清理;不能证明快手线上认证机制,也不能代替真实直播或创作者中心复测。本文以测试覆盖范围说明工程验证,不将内部用例总数作为线上登录可靠性的证明。
后续若要判断保留首页是否为必要条件,需要补充对照实验,而不是只重复成功路径:
| 组别 | 操作条件 | 重点记录 |
|---|---|---|
| A | 新环境导入文本,直接访问目标页 | 最终跳转与目标账号状态 |
| B | 先登录首页,在同标签转到目标页 | 与直接访问的差别 |
| C | 保留已登录首页,新标签访问目标页 | 与覆盖首页的差别 |
| D | C成功后关闭首页并持续观察 | 立即、延迟或没有变化 |
| E | 正常关闭上下文,再使用同目录重启 | 持久化恢复与重新验证结果 |
这张表是后续计划,没有补造实验结果。各组应使用受控的独立目录或副本,记录账号、网络、浏览器版本和时间条件,并分别检查推荐页、直播与创作者中心。即使观察到 Cookie 值发生变化,也还需要证明该变化与目标页登录之间的联系。
对类似问题,我会先问“在哪个环境、哪个页面、哪个阶段验证失败”,再决定是否重新登录。只有当排查粒度足够细,才能分辨真正的凭据失效、账号环境混用,以及页面执行方式带来的差异。
参考资料
以下7项为可公开访问的通用资料,于2026年10月26日查阅,用于解释浏览器与自动化行为,不构成快手私有认证协议说明。
- MDN:Using HTTP cookies,Cookie 作用域、属性与 JavaScript 访问限制。
- RFC 6265 §4.2:Cookie,请求头语义、缺失的存储属性与同名 Cookie 顺序边界。
- Playwright Python:Authentication,认证状态复用及 sessionStorage 单独处理。
- Chrome:Browse in Incognito mode,多个无痕窗口的会话关系。
- Playwright Python:Request.header_value,读取请求头及普通 headers 的限制。
- Playwright Python:BrowserType.launch_persistent_context,持久目录用途与并发使用限制。
- Playwright Python:Pages,同一上下文中的多个页面。
作者自有案例材料(未公开)
- ksDM
session.py,固定版本352bc24:Cookie 捕获、解析、身份检查与任务标签实现。 - 同版本
diagnostics.py:调试事件与失败页面材料。 - 同版本
docs/DEVELOPMENT.md:历史需求、用户观察及离线验证记录。
以上三项属于同一私有项目的本地材料,用于说明作者案例的依据,不计为公开参考链接或独立复现实验。正文提供了脱敏日志节选、分页面反馈记录及双标签结构示意;日志仅说明所记录的执行进度,反馈表保留证据缺口,结构示意用于解释实现,不冒充实际浏览器截图。本文未公开项目完整源码、浏览器状态文件或真实凭据。