网页里的 class 为什么像乱码?用一个榜单理解生成类名
查看网页代码时,经常能碰到这样的内容:
1 | <div class="aK7mQ2pL">Billy 的代码手记</div> |
昵称能看懂,aK7mQ2pL 却不知道是什么意思。它是用户编号吗?浏览器临时生成的吗?如果过一会儿变了,网页为什么还不会乱?
先记住一个关系:class 可以用来给元素标记身份,CSS 通过这个标记找到元素并设置样式。名称不需要有英文含义,只要引用它的地方能对应起来。
下面用一个虚构榜单,从最普通的类名开始,逐步换成工具生成的名称。榜单中的昵称、排名和短字符串都是演示数据;后面的匿名评论区观察另行注明实测内容,不展示真实昵称、评论正文或视频链接。
class 到底是什么
先看最简单的一行:
1 | <div class="nickname">Billy 的代码手记</div> |
其中 class="nickname" 给这个元素加上了一个名叫 nickname 的类。再写一条 CSS:
1 | .nickname { |
CSS 中的点号表示按类名选择元素。.nickname 找到带有 nickname 类的元素,然后把文字颜色设为紫色。
浏览器不会理解 nickname 是“昵称”才应用这条规则。它匹配的是名称。把两边都改成下面这样,效果仍然一样:
1 | <div class="aK7mQ2pL">Billy 的代码手记</div> |
1 | .aK7mQ2pL { |
所以,难读的名字并没有特殊能力。这里改变的只是标记的名称,文字和颜色都没有改变。
一个元素还可以有多个类,用空格分隔。例如 class="rank first" 同时包含 rank 和 first,并不是一个带空格的长名称。MDN:HTML class 属性
榜单里为什么会出现那么多类名
假设榜单有三条记录:
| 排名 | 昵称 | 徽章 |
|---|---|---|
| 1 | Billy 的代码手记 | 编程开发 |
| 2 | 云端运维笔记 | 系统与运维 |
| 3 | 今天也在折腾 Hexo | 博客折腾 |
每条记录都需要布局,昵称需要文字样式,排名数字需要背景色。开发者可以分别命名:
1 | <div class="row"> |
这里四种元素各有职责:
row:排列整条记录。rank:设置所有排名数字的公共样式。first:给第一名加上不同的背景。nickname和badge:分别设置昵称与徽章的样式。
如果工具换了一套名称,结构可以变成:
1 | <div class="r_A7k2"> |
这些名称不必包含 name、badge 等前缀,这里保留前缀只是为了方便对照。
第二条记录仍然可以使用相同的行、昵称和徽章类,只把第一名的特殊样式换掉。因此,看到多个元素拥有同一个类名,通常是在复用样式,并不表示它们属于同一个用户。
名字是谁生成的,开发者需要记住它吗
在很多工程里,开发者写的是 row、nickname 这样的名称。发布前,构建工具处理源码,生成供浏览器使用的文件,也可以在这个过程中改写类名。
可以把它理解为工具维护了一份对应表:
| 源码名称 | 生成后的名称(示意) |
|---|---|
| row | r_A7k2 |
| rank | n_B8m3 |
| first | top_C9p4 |
| nickname | name_D2q5 |
| badge | badge_E3s6 |
工具不仅处理 CSS 中的选择器,还要让渲染元素的代码取得相应名称。否则只改一边,样式就匹配不上了。
以 CSS Modules 为例,开发者可以这样引用:
1 | import styles from './Ranking.module.css'; |
styles.nickname 可以理解为“从对应表里取出昵称样式的实际名称”。开发者使用的是 nickname 这个键,不需要记住 name_D2q5。
这段导入语法需要支持 CSS Modules 的工具链处理,不是把代码原样贴进普通 HTML 就能运行。CSS Modules 提供局部名称与生成名称之间的映射,让组件通过导入结果引用样式。CSS Modules 项目说明
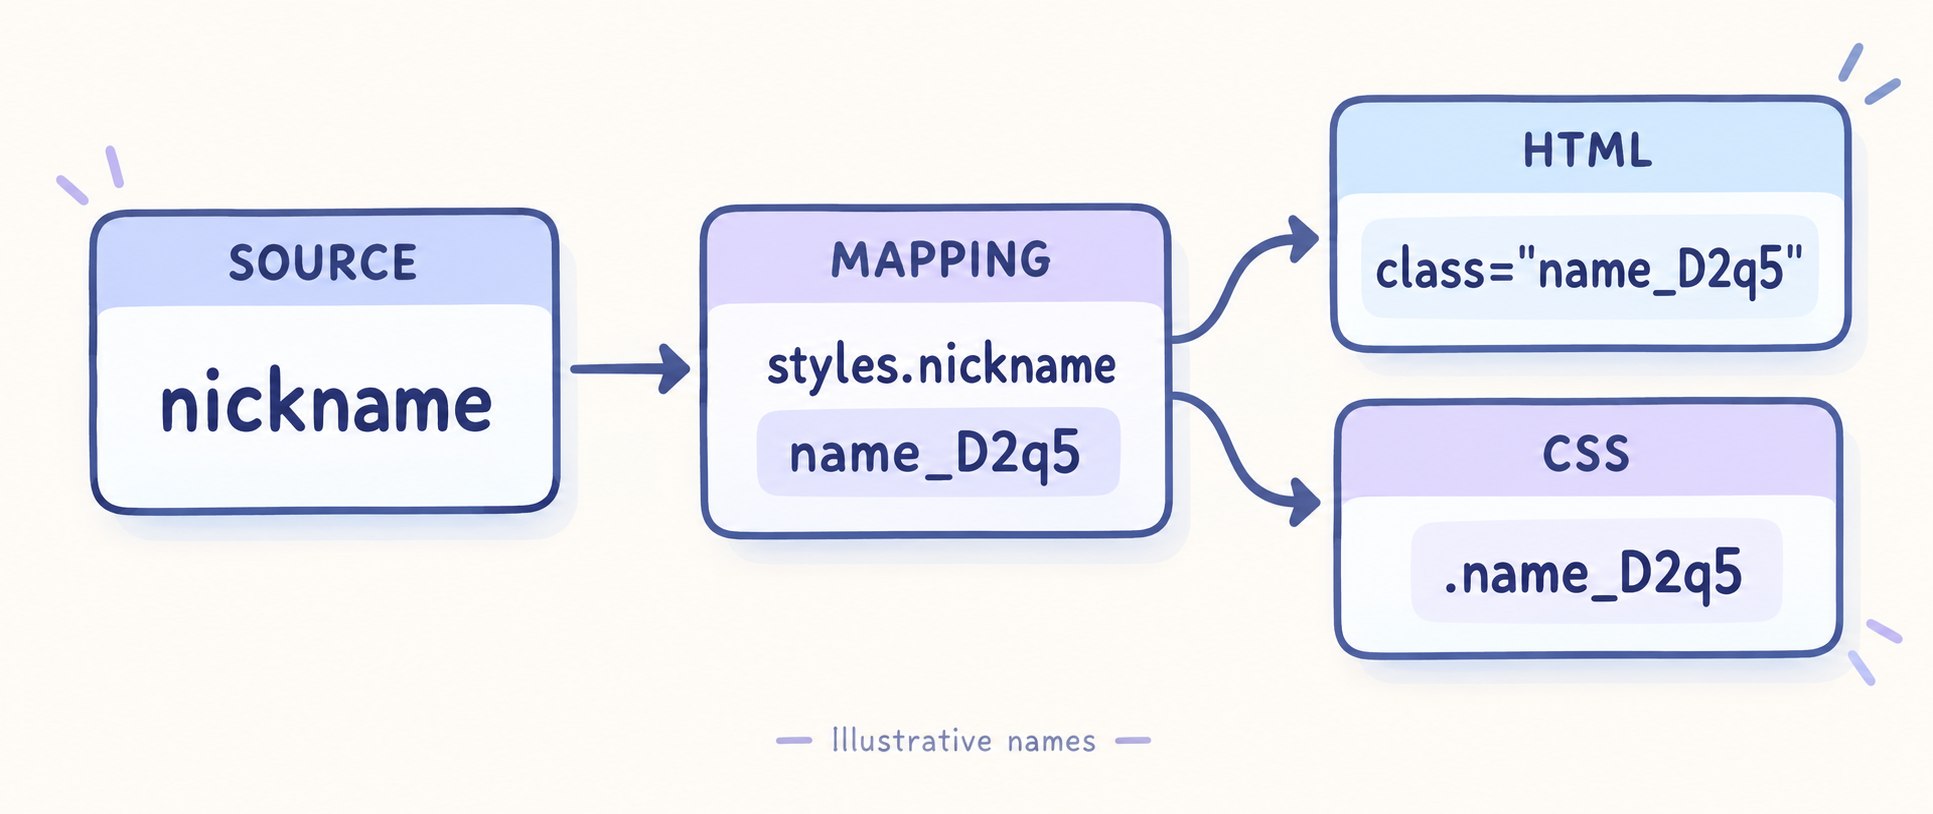
类名映射示意:HTML 与 CSS 使用同一名称;图中生成值仅为示意。
好好的名字,为什么还要换
一个页面可能有榜单、侧栏和文章卡片。三处开发者都觉得 title 是个合适的名字:
1 | /* 榜单希望标题紫色 */ |
如果它们进入同一份全局样式,且其他条件相同,后面的规则会覆盖前面的颜色。榜单标题也可能因此变蓝。
可以人为写成长名称,例如 ranking-title 和 sidebar-title;也可以让工具自动区分模块:
1 | .ranking_X7a2 { color: purple; } |
榜单使用前者,侧栏使用后者。两份源码仍然可以各写各的 .title。
这就是自动命名的一项实际价值:让不同组件中的同名样式不容易相互干扰。 但局部类名并不会阻止所有样式影响,文字继承、全局选择器等仍然需要考虑。
看起来随机,就一定是随机数吗
不一定。常见生成方式包括增加文件或组件前缀、生成哈希标识,以及使用序号或其他自定义规则。
哈希可以粗略理解为:把一些输入交给算法,得到一段标识。输入可能包括文件路径、局部名称、样式内容或额外配置,具体取决于工具。相同算法和相同输入通常会得到相同结果,因此看起来像随机字符,并不意味着每次刷新都重新随机生成。
也不要尝试从示意字符串中读取业务信息。它一般不能告诉你用户是谁、排名多少,更不能把字符串长度直接当作某种算法的证据。
为什么类名随时可能变化,页面却仍然正常
对于查看页面或编写外部脚本的人来说,生成类名没有长期不变的保证。今天复制的名称,下一次发布后可能就失效了。
变化可能发生在不同阶段:
| 情况 | 可能发生的事情 |
|---|---|
| 网站重新构建或发布 | 文件、配置或工具版本改变,生成名称随之变化 |
| 服务端生成页面 | 程序按自己的规则生成名称,并协调相关样式 |
| 浏览器运行脚本 | 脚本动态创建名称或替换已有名称,同时提供匹配规则 |
| 元素状态发生变化 | 原本就存在的不同类被切换,不一定生成了新名称 |
例如,一行被选中后从 row 变成 row selected,这是状态变化。它和程序临时造出一个全新的类名不是同一回事。
无论在哪个阶段改名,正常显示都依赖相同的条件:元素当前使用的类名,仍然能找到预期的样式规则。 网站自身可以同步维护这些引用,外部脚本里写死的旧名称却不会自动跟着更新。
因此,“生成类名可能变化”是使用时应有的预期;“每次刷新必然变化”则需要实际观察,不能一概而论。
动态改名是不是动态加密
只看到 class 变化,不能得出这个结论。
如果程序把 nickname 换成 name_D2q5,同时把 CSS 选择器也换掉,浏览器只需要匹配名称,没有把这段字符串解密回 nickname 的必要。
描述这种现象时,可以使用“类名生成”“动态改名”或“类名混淆”。如果还涉及接口签名、传输数据加密,那是另外需要检查的机制。
让名称难读,确实可能增加理解页面或维护固定选择器的成本,但名称本身无法隐藏浏览器已经显示的昵称和排名,也不能替代访问权限控制。
本文用 CSS Modules 解释一种常见的名称映射方式,并不据此认定某个页面一定采用了它。
实际打开评论区后,观察到了什么
为检查“名称是否每次打开都会变化”,2026 年 10 月 8 日使用浏览器自动化打开了一个公开视频的详情页,并在同一浏览器上下文内重新访问相同地址。两次都等到评论条目出现,再读取对应位置的 DOM 类名。
这里记录的是同类节点的结构与名称,不是对某位用户或某条评论的身份追踪:
| 节点位置 | 第一次加载 | 重新打开后 |
|---|---|---|
| 评论条目 | Eh0a5CD4 |
Eh0a5CD4 |
| 用户信息区域 | xRxUIIMP comment-item-info-wrap |
xRxUIIMP comment-item-info-wrap |
| 信息区域相邻的正文节点 | FduGc_lz |
FduGc_lz |
这两次观察中,对应位置的类名相同。没有观察到每次打开页面就随机换一套名称。
这并不证明它们永久固定,也没有确定其生成算法。此次未比较不同账号、不同浏览器会话或不同发布版本,也未追踪生成类名的源码,不能据此确认使用了 CSS Modules,更不能认定其目的就是反采集。
评论入口和样式类名可以同时存在
在同一视频的另一次页面检查中,评论按钮具有下面的属性组合。以下片段仅保留定位相关属性:
1 | <div |
feed-comment-icon 是 data-e2e 属性的值,不是 class。对应选择器是:
1 | [data-e2e="feed-comment-icon"] |
而 .feed-comment-icon 查找的是带这个类名的元素,两者含义不同。这解释了为什么只按 class 查找,可能找不到明明存在的入口。
可读的属性标记与难读的样式类名可以放在同一个元素上,承担不同用途。但属性存在不等于对外承诺长期稳定,页面改版仍可能调整它。
没找到节点,也可能只是还没加载
成功取得评论条目的两次观察中,从导航返回后开始计时,大约分别等待了 40 秒和 15 秒。检查按约 5 秒间隔进行,因此这是本次环境下的粗略记录,不是网站的固定加载时间。
更早的短时检查没有拿到条目,而后续检查中先出现了列表容器,再出现评论节点。这个过程提醒我们:选择器没有匹配到元素,不一定说明类名变了。 还应检查加载状态、页签、弹层和元素可见性。
实际项目为什么组合多种定位方式
本地一个评论处理项目使用了以下几种选择器。这里仅摘录定位逻辑,不展示账号配置或用户数据:
| 代码中的写法 | 依赖的条件 |
|---|---|
[data-e2e="comment-list"] |
列表元素保留该属性和值 |
[class*="comment-item-info-wrap"] |
类属性中包含这段可读字符串 |
item.nextElementSibling |
正文仍位于信息区域紧邻的下一个元素位置 |
.FduGc_lz |
正文节点仍使用这个具体类名 |
其中一段逻辑是:
1 | const sibling = item.nextElementSibling; |
它先找到相邻元素,再检查类名,最后读取文字。本次页面检查中的 FduGc_lz 与代码一致,说明这个判断确实对应了当时观察到的正文结构。
如果以后名称改变,这条分支就不会执行。项目另有备用选择器,但能否读到正文还取决于备用规则与新结构是否匹配。这里只能指出维护风险,不能把尚未发生的变化写成已确认的故障。
属性、类名片段和相邻关系各有依赖条件,没有一种写法天然不会失效。先确认当前页面结构,再选取含义明确、作用范围合适的定位方式,比单纯把一种选择器换成另一种更可靠。
这个案例能直接支持的是“固定类名会成为代码的依赖”。至于网站是否刻意用动态改名阻碍采集,还需要另外的证据。
不安装工具,也能亲手看懂对应关系
先不搭建项目。新建一个 class-demo.html 文件,复制以下内容,用浏览器打开:
1 |
|
按照下面三步修改,每次保存后刷新页面:
- 只改 HTML:把
class="nickname"改为class="aK7mQ2pL"。文字仍在,但原来的紫色、背景和内边距不再匹配。 - 再改 CSS:把
.nickname改为.aK7mQ2pL。两边重新对应,样式恢复。 - 一起换名:把两处名称都改成
billyName。样式保持不变。
这个实验是手动改名,不是哈希生成器,也没有实现完整的 CSS Modules。它只验证最关键的一点:浏览器关心的是选择器能否匹配元素,不关心名称是否容易读懂。
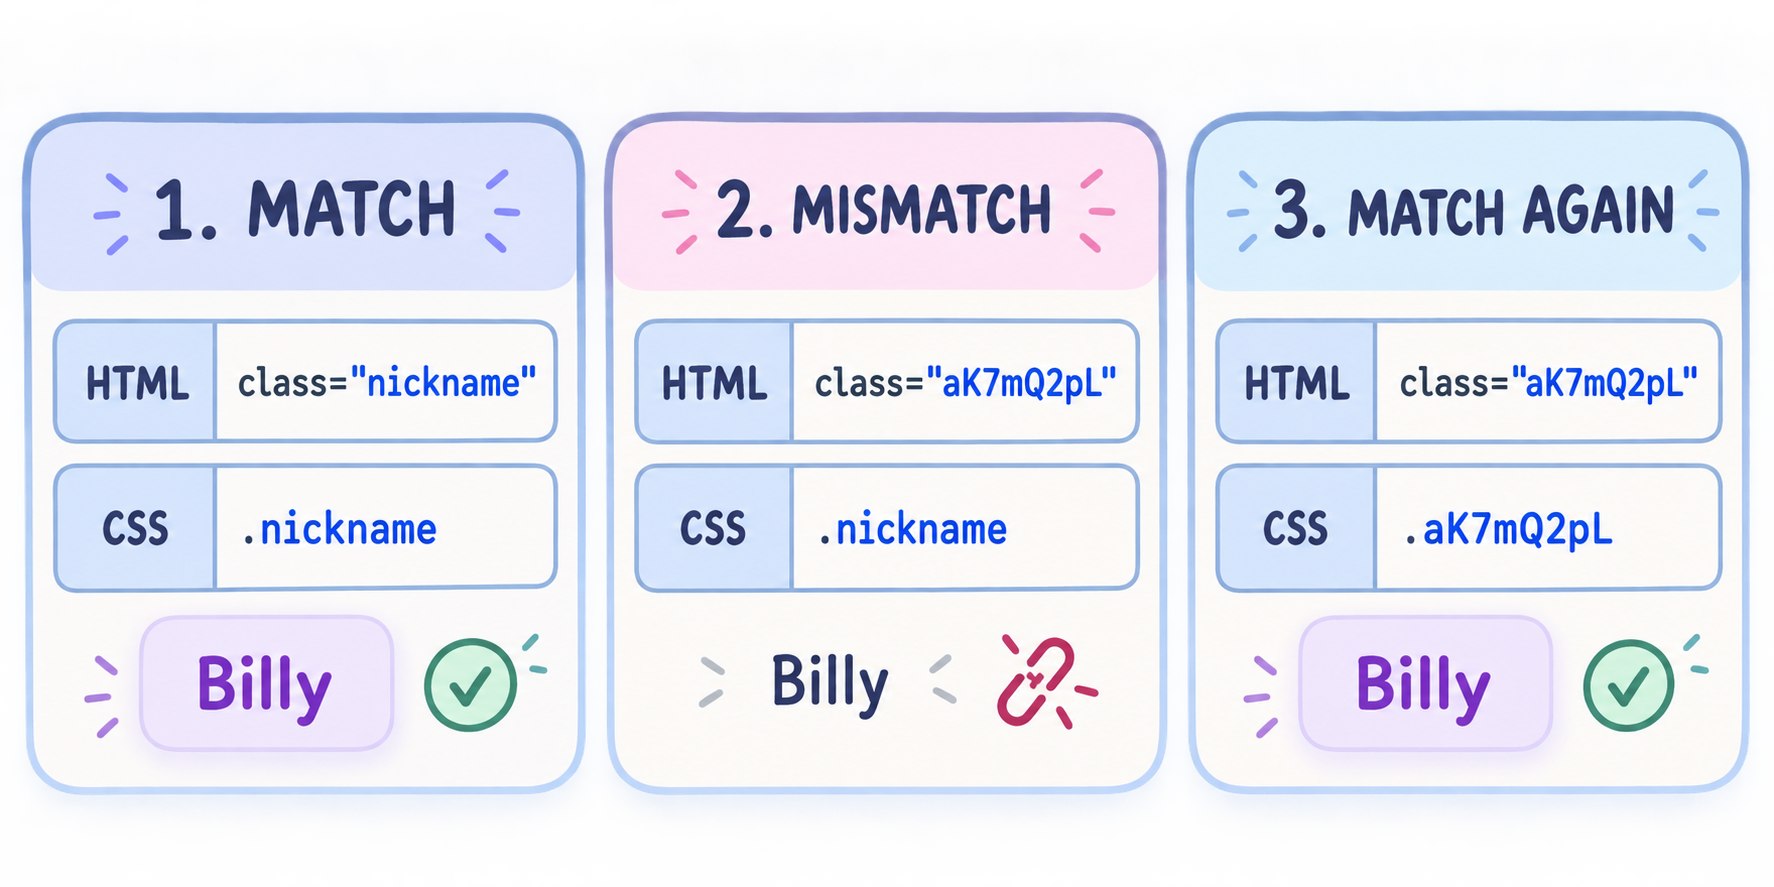
从左到右:名称匹配、只改 HTML 后失配、两边同步改名后重新匹配。
用开发者工具检查类名和样式
先选中你关心的昵称或排名元素,在开发者工具的 Elements 面板看它有哪些类,再到 Styles 面板查看实际匹配的规则。看见一个陌生名称,不必先猜算法,先确认它控制的是颜色、间距还是布局。
如果想研究名称变化,就记录同一个元素在刷新、交互前后的类名与规则,同时检查页面加载的资源内容。只有一份 HTML,通常无法确认名称是在发布前、服务端还是浏览器里产生的。
写自己的组件时,通过工具提供的映射引用样式;做自己的页面测试时,优先使用语义定位或专用测试属性,避免把某次构建后的类名当成稳定接口。
在本文的榜单示例中,昵称始终是普通文本,改变的是元素与样式之间的标识。理解这套对应关系之后,再看实际页面,就能把“名称难读”“名称发生变化”和“为什么要这样设计”分开判断。